纯稠密向量经常找不到基因符号、试剂货号;纯 BM25 找不到同义改写。根因是词项精确与语义近似不可互相替代。本方法两路召回再融合。分数尺度不同,必须走 Fusion/RRF,不能直接加分。
本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「Hybrid RAG」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 词项通道 + 语义通道的并行召回 |
| 输入 → 输出 | query → 两路排名 → RRF 后的 hits |
| 默认组合 | OpenSearch / Elasticsearch hybrid,或 Weaviate / Milvus 稀疏+稠密 |
| 何时不用 | 语料全是流畅叙述、几乎无符号货号,且 Naive 已够 |
核心机制
$$
\mathrm{RRF}(d)=\sum_i \frac{1}{k+\mathrm{rank}_i(d)}
$$
$k$ 为平滑常数(常用 60)。可比的是名次,不是 BM25 与余弦的原值。
段末注释:倒数排名融合(Reciprocal Rank Fusion,RRF) = 按各通道排名倒数加权,避免分数尺度问题。
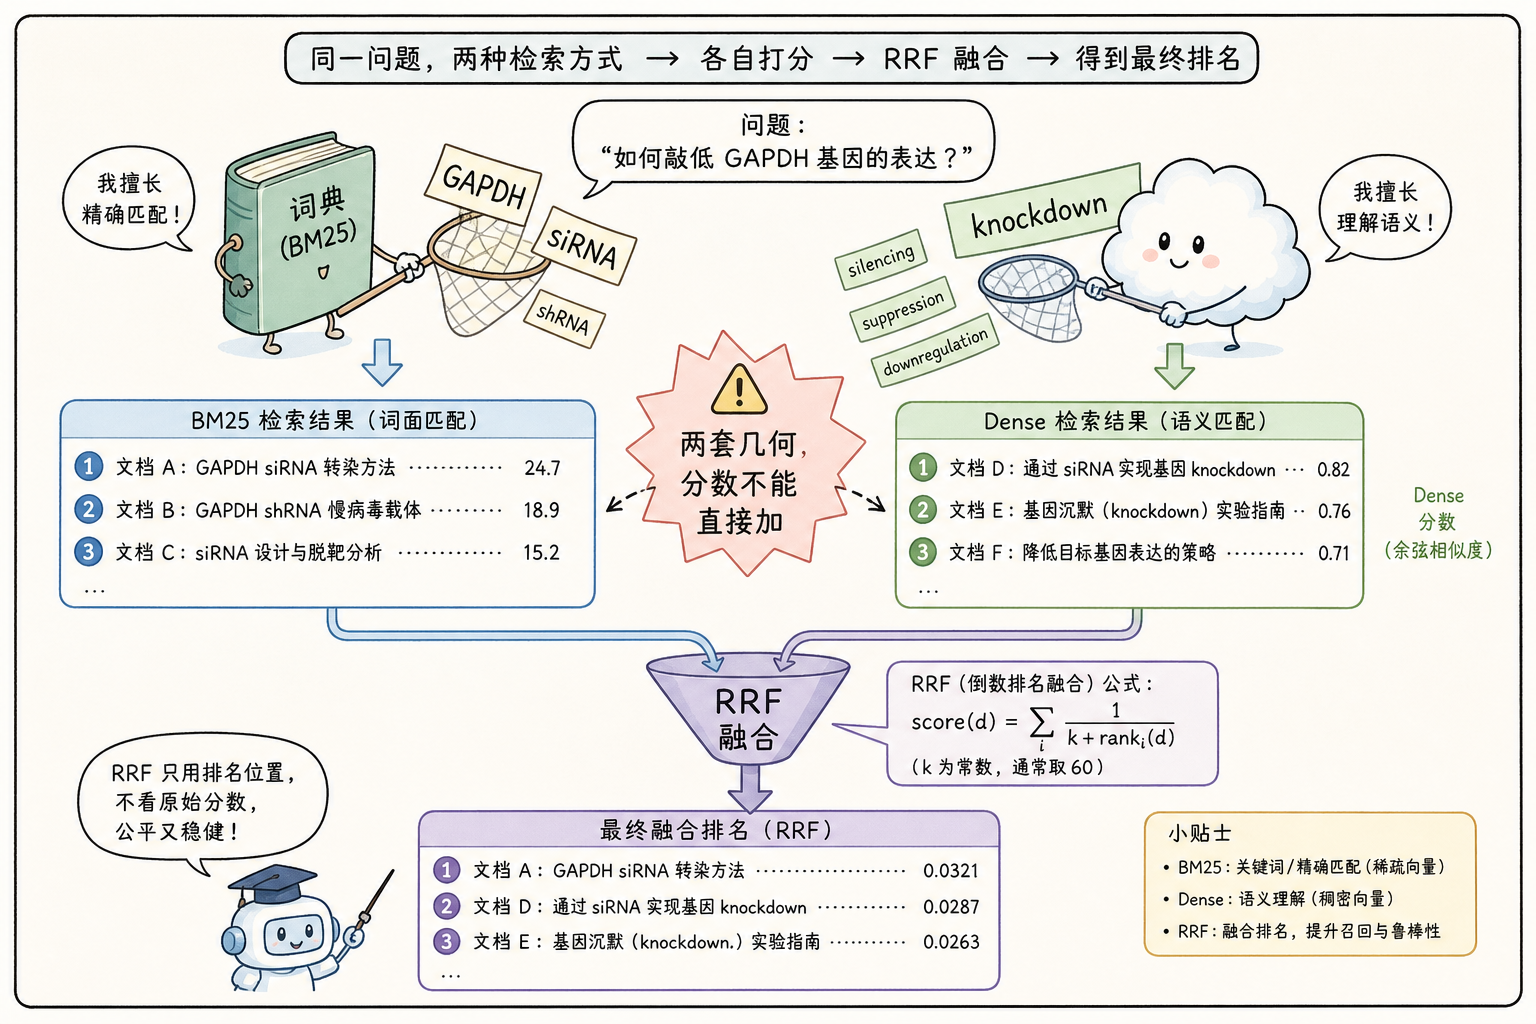
实现路径与心智:同一 query 并行打倒排(词项)和向量 ANN(语义),得到两份排名,用 RRF 或校准后的分融合、去重。底层心智:这是两套几何里的相关性,BM25 分和余弦不在同一尺度,禁止直接相加。词项通道负责货号/基因符号,向量通道负责改写同义。
优缺点
- 优点:术语与同义同时覆盖。
- 缺点:两套索引;融合参数仍要评测。
契约与走通样例
输入
1 | {"query": "GAPDH siRNA 20 nM 处理多久"} |
中间量
BM25:含 GAPDH 的块 rank=1;dense:改写段 rank=1、货号段 rank=8。RRF($k=60$)后货号段升到 rank=2,Recall@5 从单路 $0.6$ 到 $1.0$。
输出
1 | [{"doc_id": "P-GAPDH-01-C1", "rrf": 0.0328, "ranks": {"bm25": 1, "dense": 8}}] |
社区实现
OpenSearch / Elasticsearch hybrid。风险:默认加权仍在加原始分——关掉,改 RRF。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。生产两路分别走 ES BM25 与向量 ANN,融合用 ES RRF,禁止加原始分。
1 | """BM25 式词项分与余弦分各排一列,再用 RRF 合名次。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
每路 top_k |
50 | 融合池宽度 |
| RRF $k$ | 60 | 越小越惩罚靠后的名次 |
top_n |
20 | 交给精排或生成 |
失效—信号—螺丝
- 直接加分:某一通道主导。信号:一路分数量纲大一个数量级。螺丝:改 RRF。
- 货号仍漏:BM25 分析器切碎符号。螺丝:keyword 字段 / n-gram。
- 近重复占满:两路同一段。螺丝:按
chunk_id去重。
规模(100 篇生物学 PDF)
倒排+向量磁盘 约 2–6 GB;建库 0.6–2 GPU·h(含 BM25)。在线两路并行,时延接近较慢的那一路。