Naive-RAG

要把语料外知识注入生成,但只有「一嵌一检一拼」。复杂问、术语别名、多跳关系会漏召回,且没有重排消化噪声。根因是单次向量检索没有改写、多路与精排。本方法提供可运行的最小闭环,用来验证需求而不是当生产上限。它不解决查询与文档措辞不对齐(Query Rewrite)和排序噪声(Rerank)。

本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「Naive RAG」方法。

定位

维度 内容
角色 索引召回的最小闭环(检索+拼接生成)
输入 → 输出 query + 向量索引 → top-k chunks(生成只是把 hits 塞进 prompt)
默认组合 FAISS / Qdrant / Milvus + bge-m3 或 e5
何时不用 准确率敏感、多跳、术语货号密集(改 Hybrid / Advanced)

核心机制

$$
\mathrm{score}(q,d)=\cos(e_q,e_d)
$$

取 $T_k=\mathrm{top}\text{-}k$,拼进 LLM。没有第二路信号。

段末注释:$e_q,e_d$ = 查询与文档的嵌入向量;整条系统就是嵌入空间一次近邻。
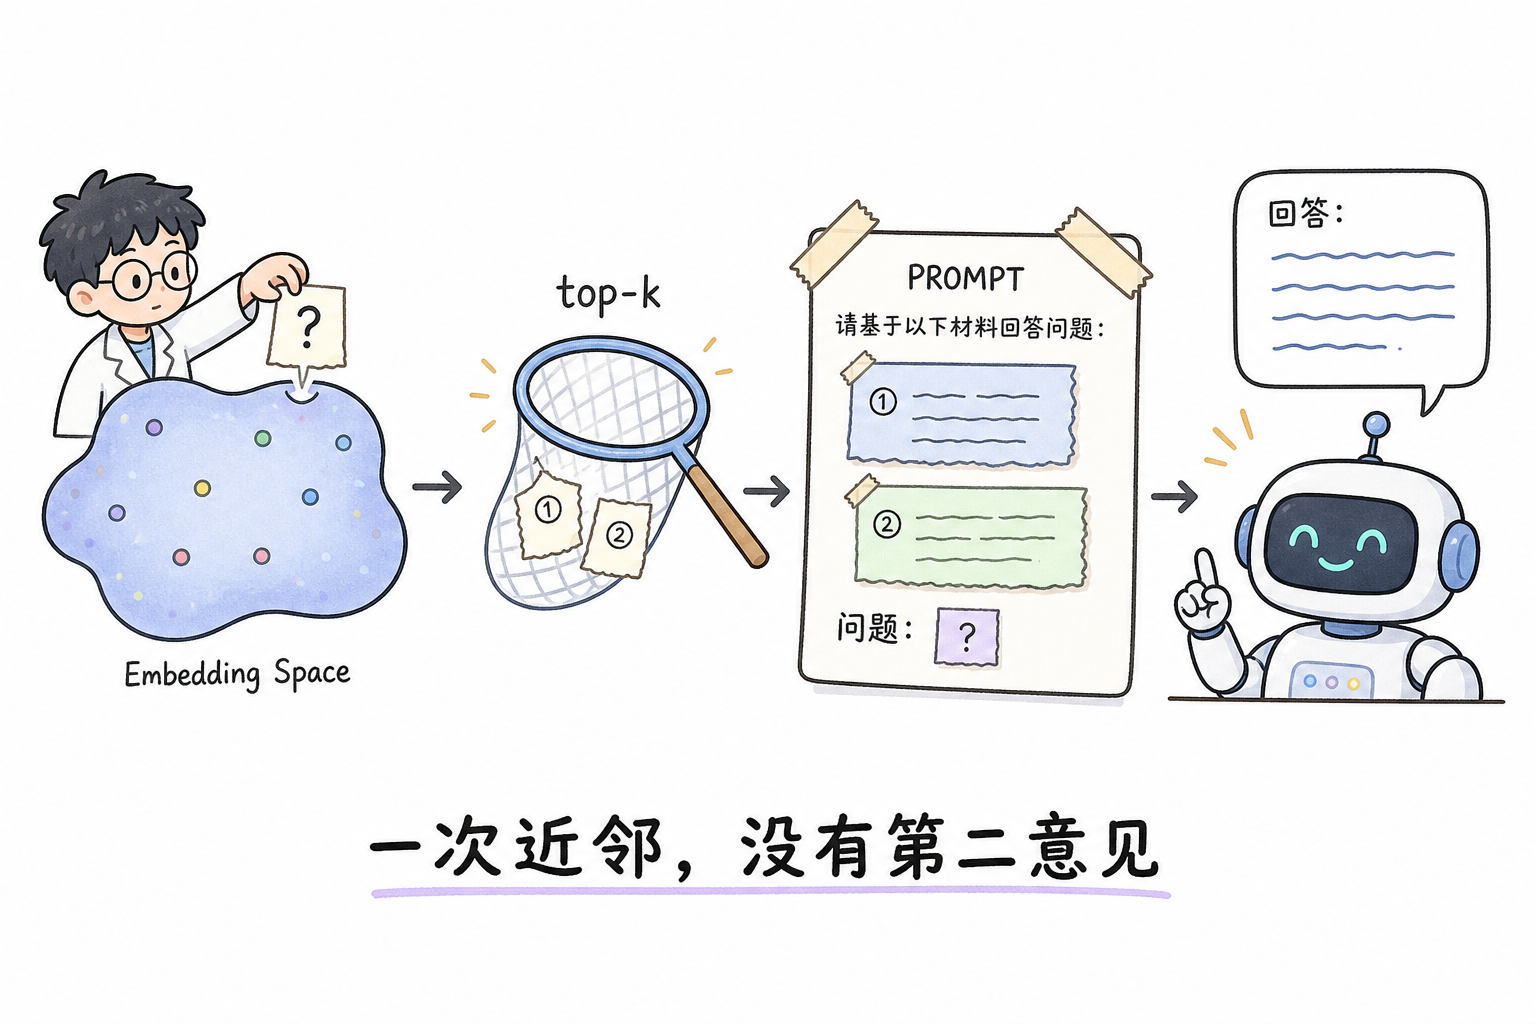
图 1 一嵌一检一拼:近邻网捞到的块直接进 prompt,没有改写或精排

实现路径与心智:离线用同一 embedder 把 chunk 写成 ANN 里的点;线上把 query 编成一个点,余弦取 top-k,拼进 prompt。底层心智:整条系统就是嵌入空间里的一次近邻查找,没有第二意见。漏召回只能改切分、模型或 $k$,不存在重排/改写这层纠偏。

优缺点

  • 优点:实现最短,适合 POC。
  • 缺点:漏召回与噪声同时存在;多跳几乎必失败。

契约与走通样例

本节点交付 hits。下面生成仅示意最小闭环。

输入

1
{"query": "How long after GAPDH siRNA before RNA extraction?", "top_k": 2}

中间量

$\cos(q,d_{\text{48h}})=0.86$,$\cos(q,d_{\text{actin}})=0.41$。$k=1$ 只注入 48 h 块; $k=2$ 多注入弱相关块。

输出

1
2
3
4
[
{"rank": 1, "doc_id": "P-GAPDH-01-C1", "score": 0.86},
{"rank": 2, "doc_id": "P-ACTB-09-C3", "score": 0.41}
]

社区实现

FAISS / Qdrant / Milvus + bge-m3。风险:嵌入与语料领域不匹配时,阈值形同虚设。

工程落地

最小可运行示例

复制为 .py 后直接运行(仅标准库)。生产把词袋换成 bge-m3,把线性扫描换成 FAISS / Qdrant / Milvus。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
"""一次嵌入、一次近邻。没有第二路信号。"""
from __future__ import annotations

import math
from dataclasses import dataclass


def bow(text: str) -> dict[str, float]:
"""教学用词袋。生产:sentence_transformers / FlagEmbedding 的 encode。"""
tf: dict[str, float] = {}
for t in text.lower().split():
tf[t] = tf.get(t, 0.0) + 1.0
return tf


def cosine(a: dict[str, float], b: dict[str, float]) -> float:
keys = set(a) | set(b)
dot = sum(a.get(k, 0.0) * b.get(k, 0.0) for k in keys)
na = math.sqrt(sum(v * v for v in a.values()) or 1e-9)
nb = math.sqrt(sum(v * v for v in b.values()) or 1e-9)
return dot / (na * nb)


@dataclass
class Chunk:
"""待检索块。生产对应向量库里的一条 point。"""

doc_id: str
text: str


class BruteForceIndex:
"""全库余弦 top-k。生产对应 faiss.IndexHNSWFlat。"""

def __init__(self, chunks: list[Chunk]) -> None:
self.rows = [(c, bow(c.text)) for c in chunks]

def topk(self, query: str, k: int) -> list[tuple[Chunk, float]]:
qv = bow(query)
scored = [(c, cosine(qv, v)) for c, v in self.rows]
scored.sort(key=lambda x: -x[1])
return scored[:k]


if __name__ == "__main__":
index = BruteForceIndex(
[
Chunk("P-GAPDH-01-C1", "48 h before RNA extraction after GAPDH siRNA"),
Chunk("P-ACTB-09-C3", "actin loading control protocol"),
]
)
print([(c.doc_id, round(s, 2)) for c, s in index.topk("How long after GAPDH siRNA before RNA extraction?", k=2)])

参数

参数 起点 影响
embedding_model 与语料同语种,如 bge-m3 换模型必须重建索引
top_k 4 过小漏约束;过大噪声进生成
similarity cosine 须与训练/归一化一致

失效—信号—螺丝

  • $k$ 偏小:含 48 h 的块未进上下文。信号:Recall@k=0。螺丝:加大 $k$ 或先改切分。
  • $k$ 偏大:弱相关带偏。信号:Precision@k 掉。螺丝:减小 $k$ 或上精排。
  • 领域不匹配:分数虚高。螺丝:换领域嵌入,不要死调阈值。

规模(100 篇生物学 PDF)

约 3k–8k chunks:嵌入峰值 GPU 8–12 GB;索引磁盘 1–4 GB;建库 0.3–1.2 GPU·h(A10)。在线一次检索+一次生成,时延低到中。

-------------本文结束感谢您的阅读-------------