模型能说出数字,但无法指出原文最小片段,审计和纠错都做不了。根因是论断(claim)与原文片段(span)未对齐。本方法按 claim 装箱最小证据。它不提高召回,没有证据就应拒答而不是造引用。
本文属于 RAG 工程框架中的「3 重排与证据组装」环节,聚焦「Citation Packing(引用组装)」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | claim 与 span 的对齐装箱 |
| 输入 → 输出 | 草稿答案 + 证据 → 带 citation 的 claim 列表 |
| 默认组合 | LlamaIndex CitationQueryEngine |
| 何时不用 | 不对用户展示引用的内部助手,可只做 Faithfulness |
核心机制
$$
\mathrm{CiteP}=\frac{|{c:\mathrm{supported}(c,\mathrm{span}(c))}|}{|C|}
$$
段末注释:引用精确率(Citation Precision,CiteP) = 已挂引用的 claim 中,能被对应 span 支持的比例。$C$ 为拆出的 claim 集合。
定义
这对词是引用装箱的两个对齐对象,不是检索阶段的 chunk。
| claim | span | |
|---|---|---|
| 中文 | 论断 | 原文片段 |
| 来自哪侧 | 生成侧:答案草稿 | 原文侧:证据句 |
| 粒度 | 一条只说一件事,真假可判定 | 最短、连续子串,能指回 doc_id + 起止位置 |
| 非法形态 | 整句里塞多个数字当一条 | 整段当 citation |
草稿 GAPDH siRNA is 20 nM for 48 h. 拆成两条 claim:20 nM siRNA(剂量)、48 h(时程)。同一证据 Treat HEK293T with 20 nM siRNA targeting GAPDH for 48 h. 对齐为两个最小 span:20 nM siRNA targeting GAPDH、for 48 h。
关系:supported(c,\mathrm{span}(c)) 成立才算引用有效。草稿写成 24 h 时该 claim 对不上任何 span,应删或拒答,禁止造 doc_id。
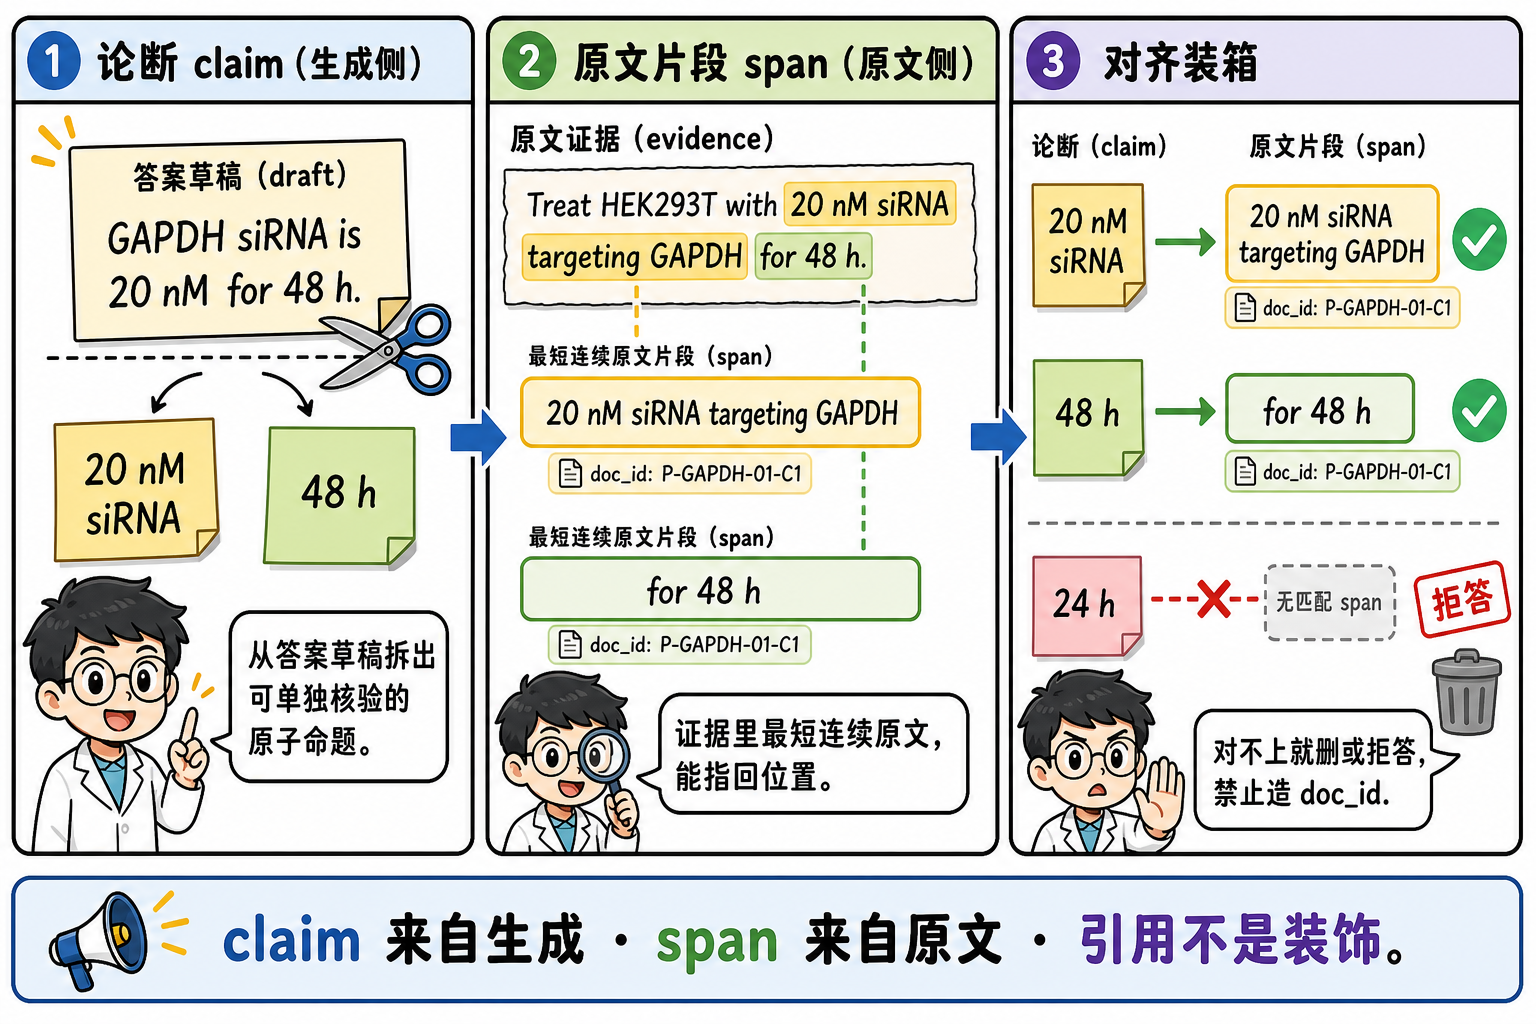
实现路径与心智:先得到答案草稿,拆成 claim,每条对齐到原文最小 span,对不上的删或改写。底层心智:答案是一组可核验命题,引用不是装饰。本步不提高召回。
优缺点
- 优点:可审计。
- 缺点:对齐模型有额外时延。
契约与走通样例
输入
1 | {"draft": "GAPDH siRNA is 20 nM for 48 h.", "evidence": ["Treat HEK293T with 20 nM siRNA targeting GAPDH for 48 h."]} |
中间量
两条 claim 分别被同一证据句中的两个最小 span 支持,CiteP=$1$。若草稿写成 24 h,该 claim 无 span,应删或拒答。
输出
1 | { |
社区实现
LlamaIndex CitationQueryEngine。风险:整段当 citation,CiteP 虚高但审计无用。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。生产把字面对齐换成 NLI / LlamaIndex CitationQueryEngine。
1 | """按 claim 装箱最小原文 span;对不上则丢弃,禁止造 doc_id。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
| 最小 span | 含数字的最短子串 | 过长失去定位 |
| 无对齐策略 | 丢弃该 claim | 禁止伪造 doc_id |
失效—信号—螺丝
- 乱挂引用:CiteP 低。螺丝:强制 NLI 通过才挂。
- 覆盖高精确低:螺丝:拆细 claim。
- 召回为空仍输出数字:螺丝:拒答。
规模(100 篇生物学 PDF)
可选 NLI GPU 4–8 GB。在线每问 +100–600 ms(随 claim 数)。