候选里已经有正确答案,但排在第 20 名,进不了生成窗口。根因是双塔/稀疏召回的排序分辨率不够。本方法用交叉编码器(Cross-encoder,CE)精排。若 Recall@k 本身低,精排无效,应先改召回或切分。
本文属于 RAG 工程框架中的「3 重排与证据组装」环节,聚焦「Retrieval Rerank centric RAG」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 候选集上的精排 |
| 输入 → 输出 | 召回池 $k$ 条 → Cross-encoder Top-$n$($n\ll k$) |
| 默认组合 | bge-reranker-v2-m3;或 Cohere Rerank API |
| 何时不用 | 池中已无金标准;P95 不允许 +80–400 ms |
核心机制
对池中每条算 $s(q,d)=\mathrm{CE}(q,d)$,取 Top-$n$。评测用精排后 nDCG@n。
段末注释:双塔(bi-encoder) = 查询与文档分塔编码再点积/余弦,文档可预计算、能 ANN;交叉编码器(Cross-encoder,CE) = 把 $(q,d)$ 拼成一对做 token 级交互,输出 $P(\mathrm{rel}\mid q,d)$。
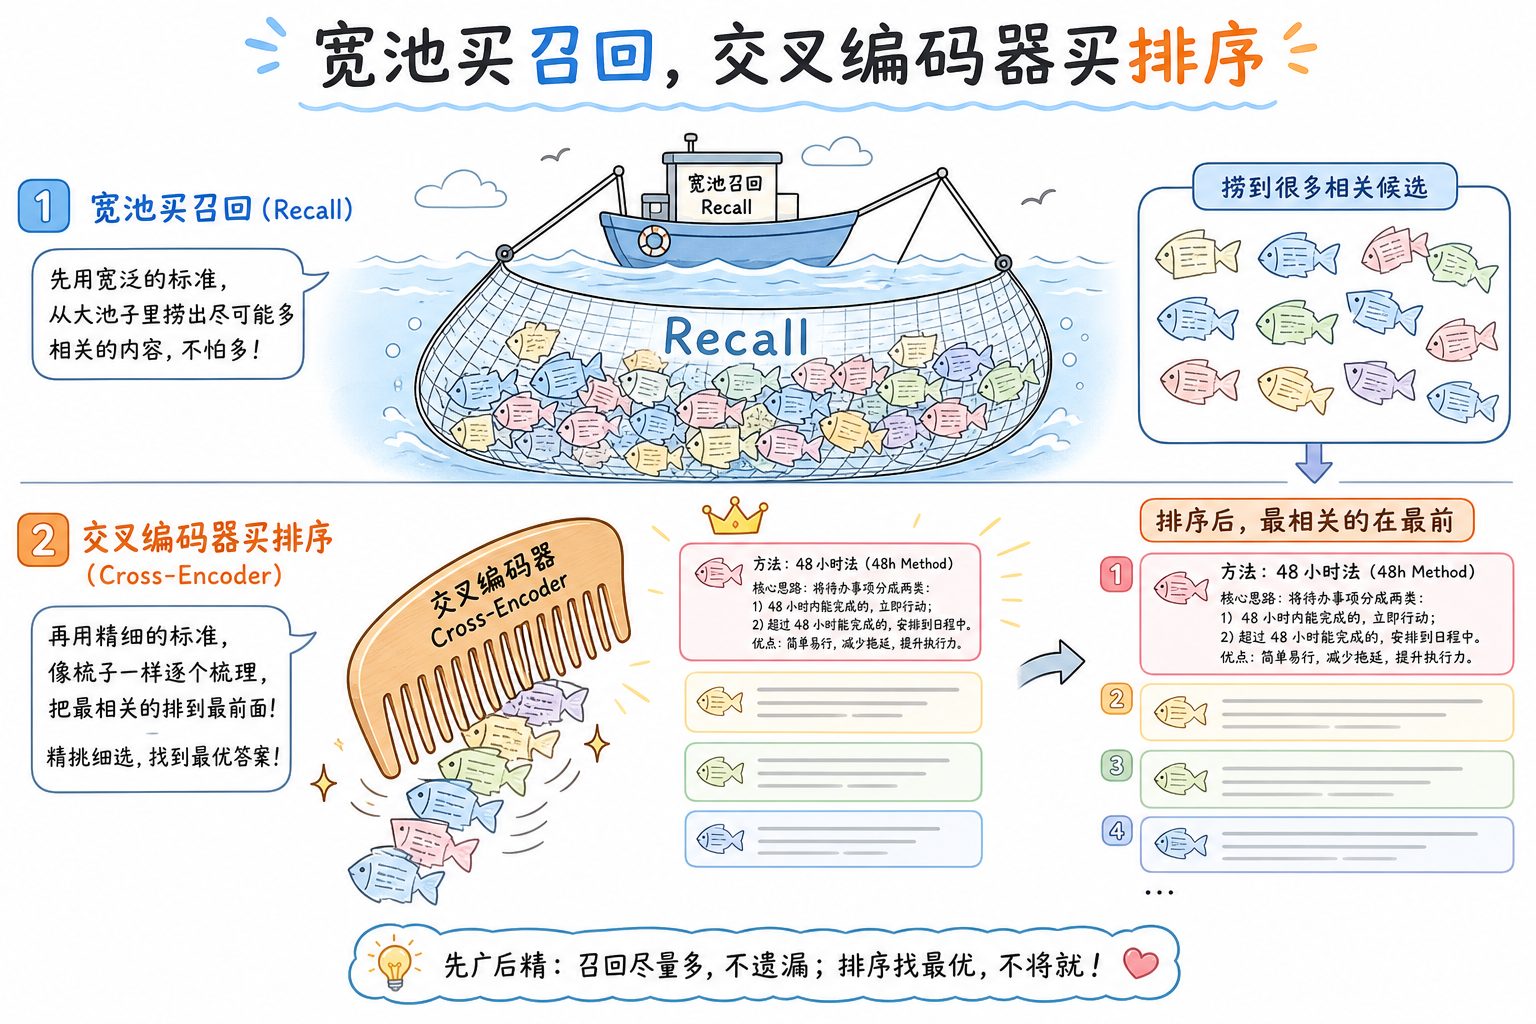
实现路径与心智:双塔/稀疏(可再经融合)先以低成本捞宽池($k$ 大),再用 CE 对每对 $(q,d)$ 做一次完整前向,按新分取 $n\ll k$。底层心智:第一段买 Recall,第二段买排序分辨率;精排看不见池外的金标准。池子里没有正确答案时,换更强 reranker 无效。
实现方式
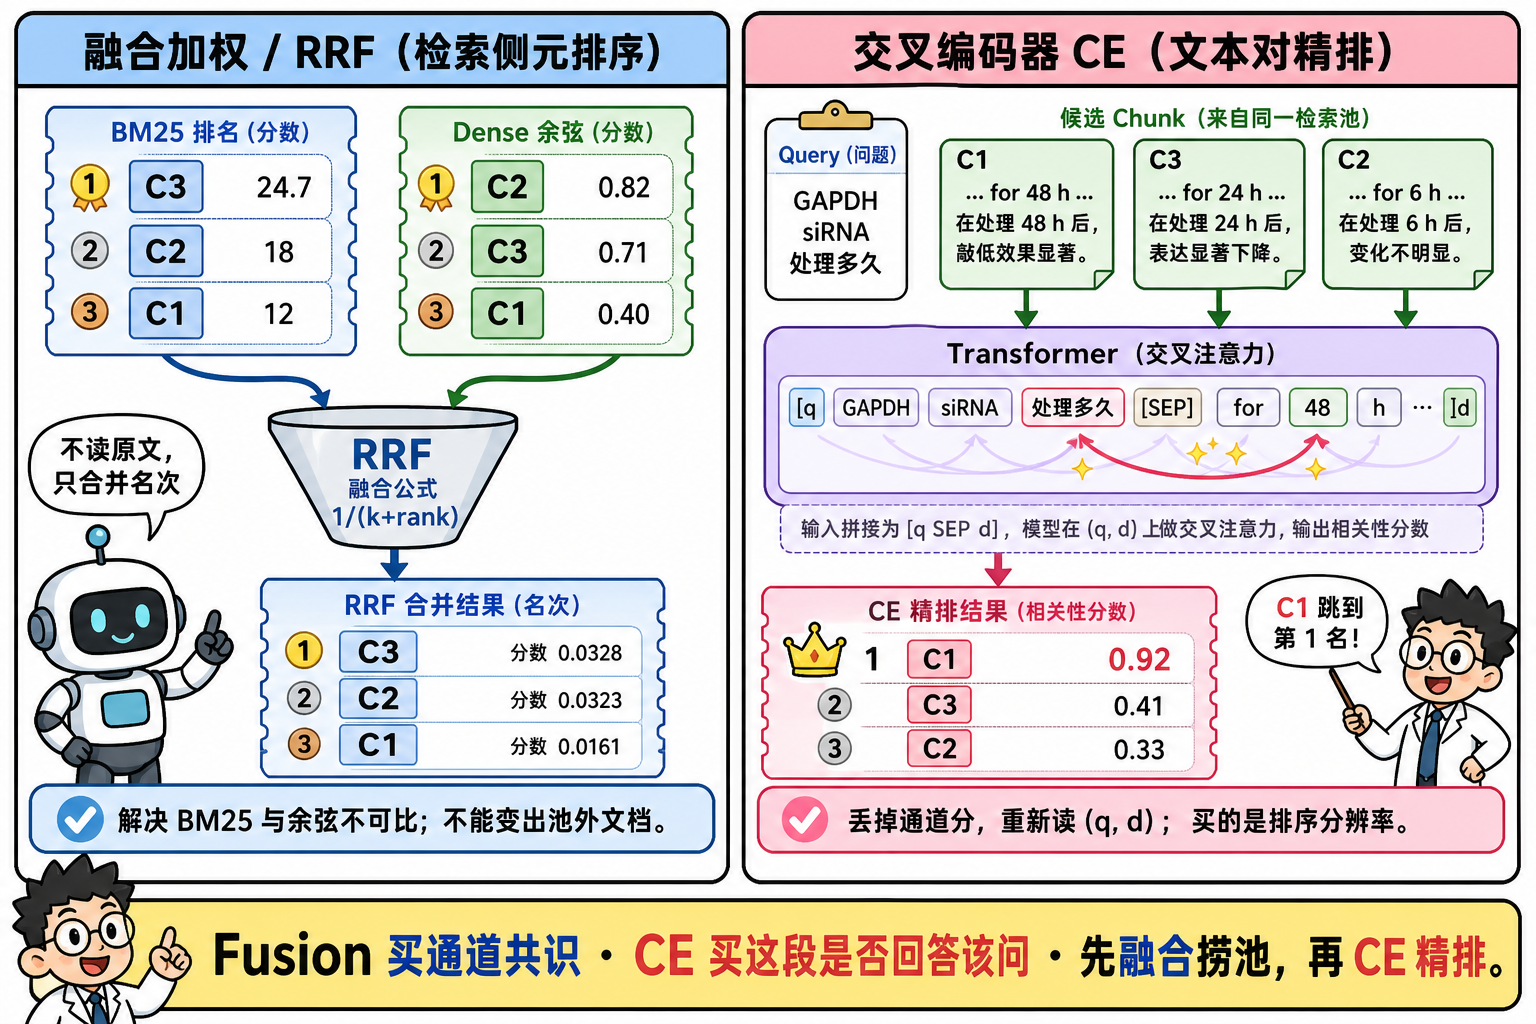
CE 不再使用 BM25 / 余弦原值。把 query 与文档拼成 $[q;\mathrm{SEP};d]$,过一遍 Transformer,用注意力直接看「这段能不能回答这个问题」,得到单一相关性分。成本随 $k$ 线性涨:每问要对池内每条做一次前向。
社区默认 FlagEmbedding bge-reranker-v2-m3:
1 | pool = retriever.search(query, k=50) # 可已是 RRF 融合结果 |
截断长度必须盖住方法句;query 与 doc 被切掉 48 h 时,CE 看不见时程。
与融合加权的区别
融合(RRF / 通道加权)是在已经排好的多路名单上做元排序:合并名次或校准后的通道分。它不读原文,不产生新相关性信号,也变不出任何一路都没召回的文档。CE 丢掉通道分,重新读文本对。
| 融合加权 / RRF | Cross-encoder 精排 | |
|---|---|---|
| 输入 | 各路 rank_list 或原始分 |
文本对 $(q,d)$ |
| 看什么 | 通道共识(谁在多路都靠前) | query 与文档的 token 交互 |
| 分数含义 | 「检索器们有多同意」 | 「这段是否回答该问」 |
| 能否重排池内顺序 | 只能按通道名次/分重组 | 可以:召回第 20 提到第 1 |
| 新召回 | 不能 | 也不能(看不见池外) |
| 成本 | 毫秒、无 GPU | 每问 +80–400 ms,随 $k$ 涨 |
融合解决 BM25 分和余弦不可比;CE 解决 双塔/稀疏的排序分辨率不够。二者串联:先融合买 Recall,再 CE 买 Precision。只做加权融合,货号段可能进了池但仍排在综述段后面。
优缺点
- 优点:排序提升最稳、可单独评测。
- 缺点:算力随池大小线性涨。
契约与走通样例
输入
1 | {"query": "GAPDH siRNA 处理多久", "pool": ["C1-48h", "C2-actin", "C3-review"]} |
中间量
召回 rank:C3, C2, C1。CE 分:C1=$0.92$,C3=$0.41$,C2=$0.33$。精排后 C1 第一,nDCG@3 从 $0.63$ 到 $1.0$。
输出
1 | [{"rank": 1, "doc_id": "C1-48h", "ce": 0.92}] |
社区实现
bge-reranker-v2-m3(FlagEmbedding compute_score)。风险:query 与 doc 长度截断切掉 48 h;把 CE 当成融合加权的替代——通道共识解决不了「池内第 20 名该不该进窗口」。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。教学用词重叠代替 CE 前向;生产换成 FlagEmbedding.FlagReranker。
1 | """宽召回后对 (query, doc) 重打分再取 Top-n。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
pool_k |
50~100 | 过小漏金标准;过大 GPU 线性涨 |
top_n |
5~10 | 进生成的条数 |
| 截断长度 | 覆盖方法句 | 过短切掉剂量/时程 |
失效—信号—螺丝
- 池内无金标准:nDCG 不动。螺丝:回退抬 Recall。
- P95 爆:螺丝:减
pool_k或只对高价值查询精排。 - 截断:螺丝:先切段再精排。
规模(100 篇生物学 PDF)
GPU 8–16 GB。离线 5k–20k 对约 0.5–3 GPU·h;在线每问 +80–400 ms。