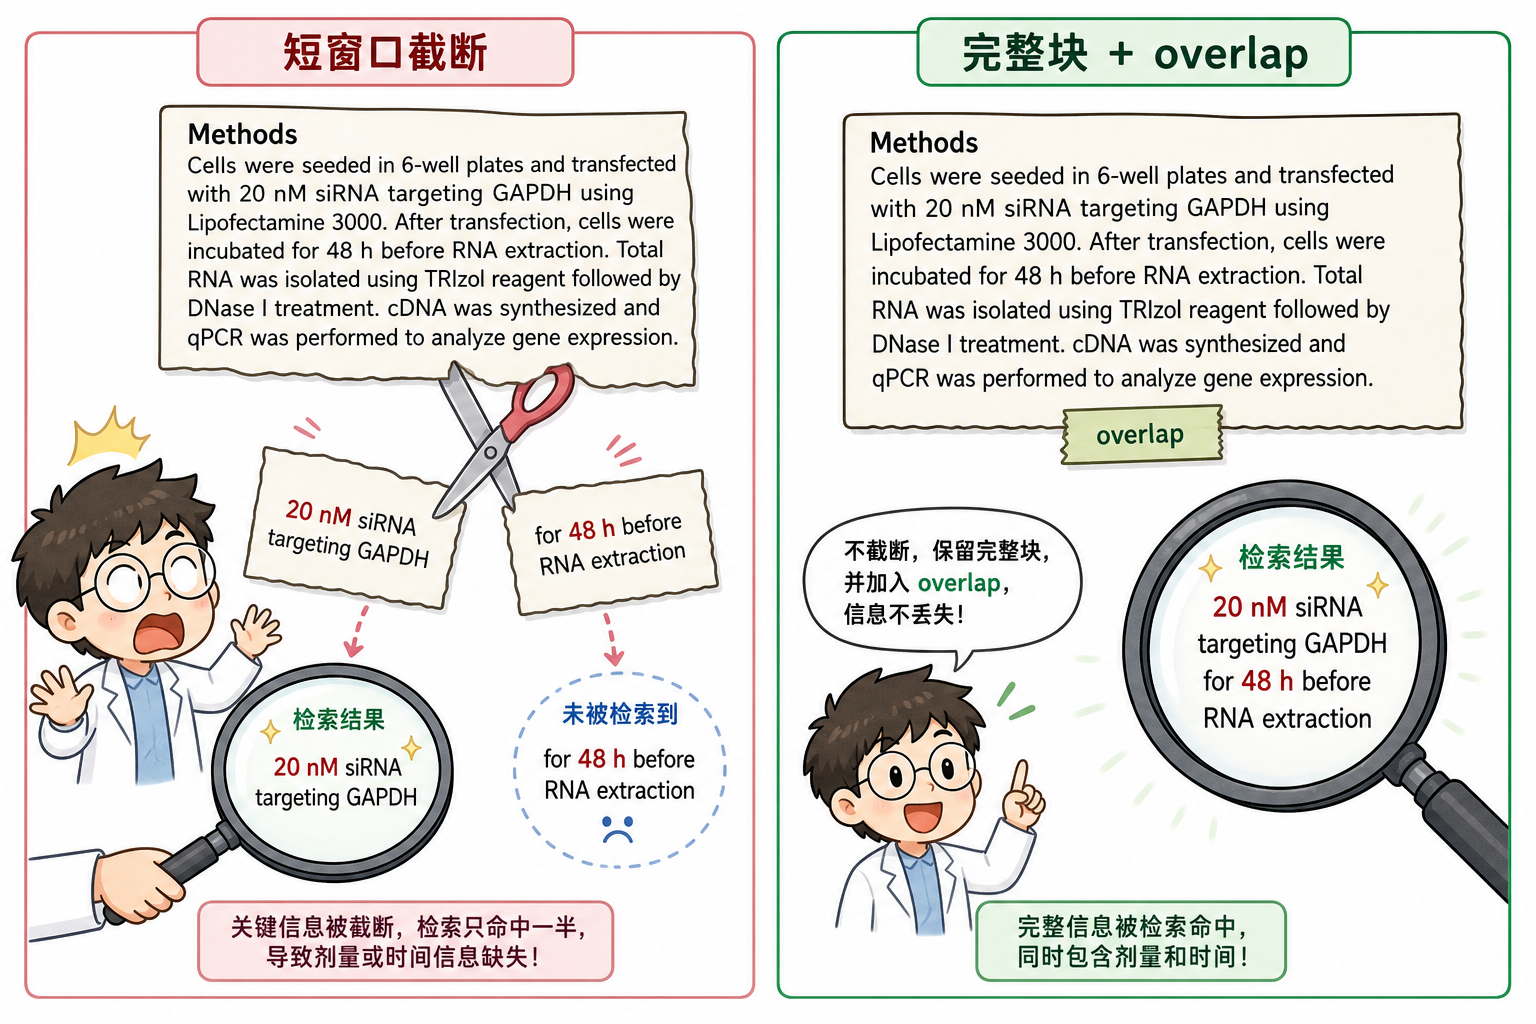
固定窗口常把同一条方法约束拆开(「20 nM siRNA」和「处理 48 h 再抽 RNA」进不同块),多约束问句只能命中一半,后面换嵌入也补不回。根因是切分边界破坏了原子事实的完整性。本方法把 chunk 策略当成可评测对象,用冻结检索的 Recall@k 选窗口与 overlap。它不解决双栏乱序和表格错切(Document Parsing)。
本文属于 RAG 工程框架中的「1 数据接入与文档切分」环节,聚焦「Chunking centric RAG」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 数据切分节点的策略选择器,不是解析器、不是检索器 |
| 输入 → 输出 | 已规整文本 → 带 chunk_id / doc_id / text / metadata 的块列表 |
| 默认组合 | 结构边界(标题/段落)+ 固定窗口网格;用同一批评测问句选参 |
| 何时不用 | 版式未还原(先 Parsing);需要章节粗召回(改 Hierarchical) |
核心机制
目标:在冻结嵌入与 $k$ 的前提下,选一组 $(s,o)$(窗口、重叠),使召回可达性最大,并控制膨胀。
$$
(s^\star,o^\star)=\arg\max_{s,o};\mathrm{Recall}@k\bigl(\mathrm{split}(D;s,o)\bigr)
\quad\text{s.t.}\quad
\mathrm{Inflation}(s,o)\le \tau
$$
段末注释:召回率@k(Recall at k,Recall@k) = 金标准相关块落入检索前 $k$ 条的比例;膨胀比(Inflation) = 切分后 token 总数 / 原文 token 数,overlap 会把它抬高。
语义完整率(Semantic Completeness,SC)解释 Recall 为何随 $s$ 变化:原子事实 $f$ 必须落在同一块内,否则多约束问句的金标准块集合被拆散。
实现路径与心智:不要把 splitter 当成「设一次就忘」的文本工具。离线路径是「枚举 $(s,o)$ → 物化 chunks → 用同一 embedder 建临时索引 → 算冻结 Recall@k / SC / Inflation → 只 persist 胜者」;线上路径只有胜出的那一套切分,不再搜索。底层心智:切分是套在冻结检索器外面的参数搜索,评测器才是决策者,肉眼看块不是。
优缺点
- 优点:离线可网格搜索,在线几乎零额外时延;对后续任何检索器都抬上限。
- 缺点:最优 $(s,o)$ 随领域与问句类型变;一套参数打全部文档会在表格/方法节失效。
契约与走通样例
本阶段输出停在 chunk 列表 + 选定策略,不生成答案。
输入
1 | { |
中间量(两种策略)
1 | [ |
评测问句 $q$:「GAPDH siRNA 处理多久再抽 RNA?」金标准需含 48 h。冻结 bge-m3、$k=5$:
fixed_40_overlap_0:含「48 h」的块排名第 7 → $\mathrm{Recall}@5=0$,SC 对该事实为 0。fixed_120_overlap_24:剂量与时程同块,排名第 2 → $\mathrm{Recall}@5=1$,SC $=1$。
故选后者。$\mathrm{Inflation}$ 因 overlap 约为 $1.2$,低于预设 $\tau=1.5$。
输出(给下游索引)
1 | { |
社区实现
默认 langchain-text-splitters(RecursiveCharacterTextSplitter)做窗口网格;LlamaIndex SentenceSplitter / SemanticSplitter 作对照臂。
- 场景:版式已规整的方法/SOP 正文。
- 接法:多套
(chunk_size, chunk_overlap)建临时索引,同一 JSONL 评测集算 Recall@k,再 persist 胜者。 - 风险:按字符数切英文论文会在句子中途断开;优先按段落/句号边界,窗口只作上限。SemanticSplitter 依赖额外嵌入,成本接近「再跑一遍 Naive」。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。冻结同一套评测问句,只换切分窗口。
1 | """多策略切块 → 冻结词重叠检索算 Recall@k → 只 persist 胜者。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
chunk_size |
英文方法节 256~512 token;过短先看 SC | 太小拆散原子事实,太大约噪声、Precision 下降 |
chunk_overlap |
约为 chunk_size 的 10%~20% |
抬 Recall,抬 Inflation;过大近重复块拖慢检索 |
k(冻结评测) |
与线上 top-k 相同,常用 5 | 评测 $k$ 与线上不一致,选出的策略会上线失效 |
embedder |
与线上同一模型(如 bge-m3) |
换模型等于换评测器,网格结果不可迁移 |
inflation_max |
1.3~1.6 | 硬约束 overlap;超了直接淘汰该策略 |
失效—信号—螺丝
- 只肉眼看一块、未跑冻结 Recall:上线后多约束问句仍漏。信号:SC 低而单句「看起来完整」。螺丝:锁评测 JSONL,禁止手选。
- overlap 过大:索引体积涨、近重复占满 Top-k。信号:Inflation $>1.6$ 且 Precision@k 掉。螺丝:降 overlap 或先按段落边界切。
- 一套参数打全部文档:表格/试剂清单被切碎。信号:Methods 子集 Recall 远低于 Abstract 子集。螺丝:按
section分策略,或把表格交给 Parsing 的merge_table。
规模(100 篇生物学 PDF)
假设约 100 篇生物学 PDF、10–15 页/篇;A10 24GB 非必需。版式已规整时,多策略网格 + 同一批评测问句约 0.5–2 CPU·h;内存 8–16 GB;磁盘增量约 0.5–1.5 GB。在线切分成本为零。