Hierarchical-Chunking-RAG

长综述要么切太碎丢掉「这是哪一节的方法」,要么切太大把试剂和统计淹没。根因是单一粒度无法同时保章节覆盖和条款精度。本方法建父子 chunk,先粗召回章节再细定位段落。它不替代图结构上的多跳(Graph RAG)。

本文属于 RAG 工程框架中的「1 数据接入与文档切分」环节,聚焦「Hierarchical Chunking」方法。

定位

维度 内容
角色 切分+召回的双粒度组织
输入 → 输出 章节树 → 父/子两套 chunk(子块带 parent_id)+ 检索时的融合排序
默认组合 LlamaIndex ParentDocumentRetriever / HierarchicalNodeParser
何时不用 短文档、无稳定章节树;需要实体多跳(Graph RAG)

核心机制

子块最终分:

$$
s(c)=\alpha, s_p(\mathrm{parent}(c))+(1-\alpha), s_c(c)
$$

只对父召回命中的节点展开子检索。$\alpha$ 是对闸门的信任。

段末注释:父块 = 章节级拼接;$s_p$、$s_c$ 为查询与父/子块的相似度;$\alpha$ 靠近 1 更信章节覆盖。
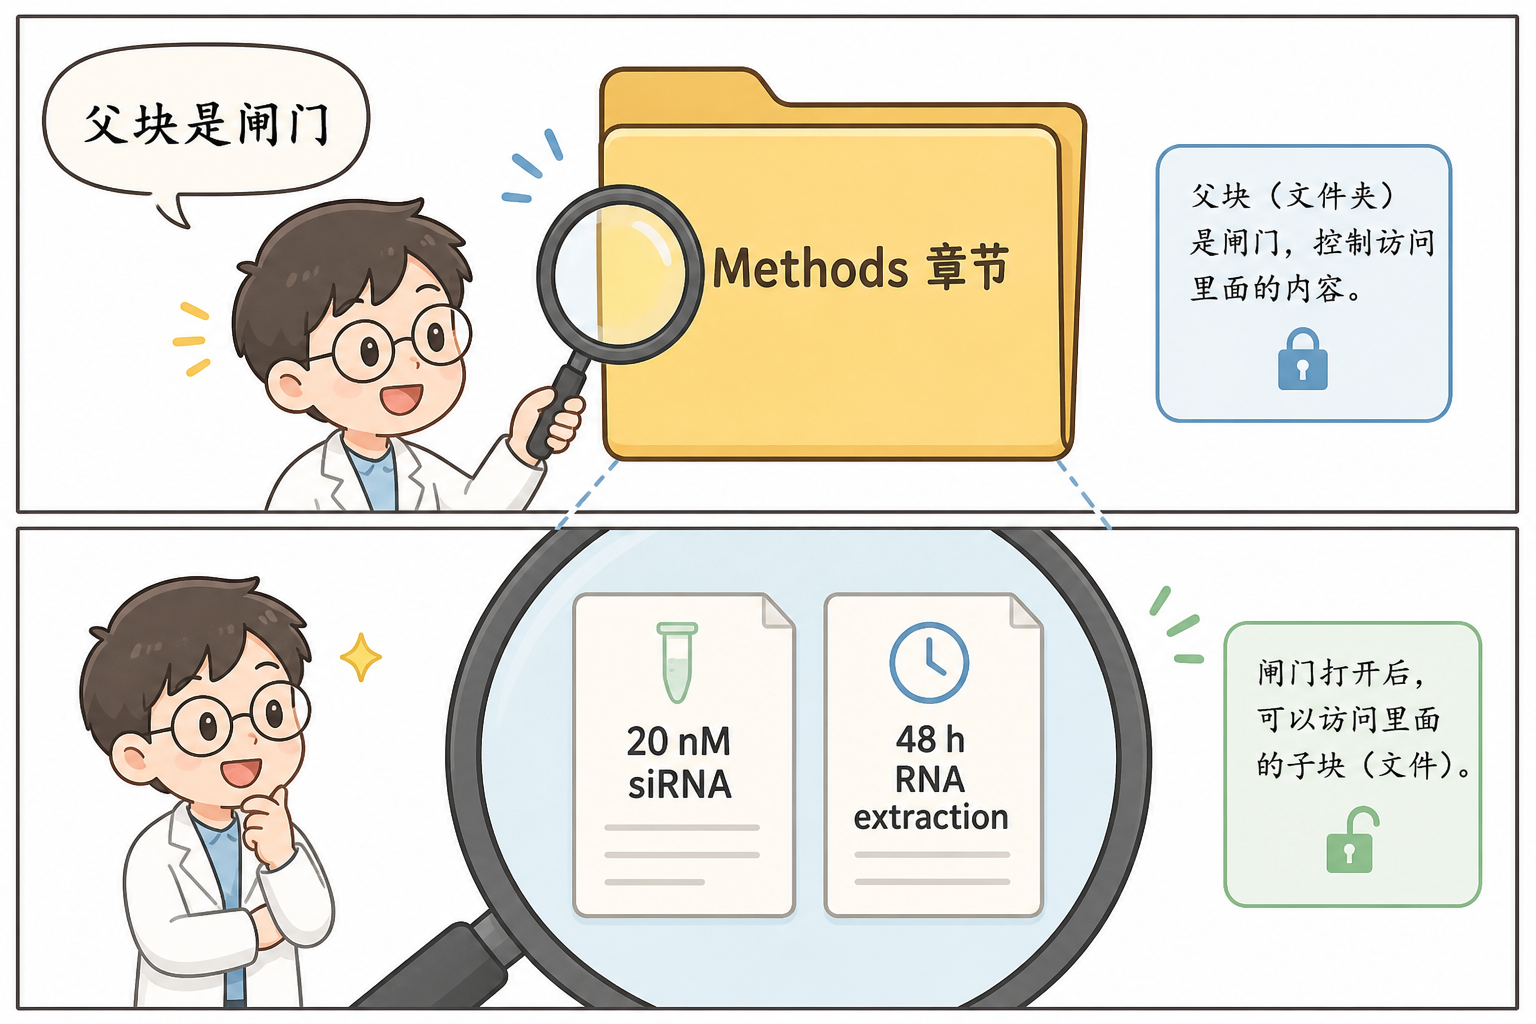
图 1 查询先命中 Methods 父块,再展开「20 nM」与「48 h」子块

实现路径与心智:先按章节树物化父块(节级拼接)和子块(段落),子块带 parent_id;查询时先搜父索引,只在命中的父节点下搜子索引,再按 $\alpha s_p+(1-\alpha)s_c$ 融合。底层心智:父块是闸门不是答案——它决定哪些子块有资格被看见;$\alpha$ 是你有多信任这道闸。父块过粗会导致整章永远展不开。

优缺点

  • 优点:长文既保章节语境又保条款精度。
  • 缺点:两套索引、双层时延;父块质量决定上限。

契约与走通样例

检索输出停在 子块排序列表,不生成答案。

输入

1
2
3
4
5
6
{
"doc_id": "P-GAPDH-01",
"sections": [
{"id": "S-methods", "title": "Methods", "paras": ["20 nM siRNA targeting GAPDH", "48 h before RNA extraction"]}
]
}

中间量

$s_p(\text{Methods})=0.72$,$s_c(\text{48 h})=0.91$,$\alpha=0.4$:

$$
s=0.4\times 0.72+0.6\times 0.91=0.834
$$

若只按父块排序,可能输给另一篇父块 $0.78$;加入子块后本路径胜出。

输出

1
2
3
4
[
{"chunk_id": "C-S-methods-2", "parent_id": "P-S-methods", "score": 0.834, "text": "48 h before RNA extraction"},
{"chunk_id": "C-S-methods-1", "parent_id": "P-S-methods", "score": 0.80, "text": "20 nM siRNA targeting GAPDH"}
]

社区实现

默认 LlamaIndex ParentDocumentRetriever / HierarchicalNodeParser;LangChain Parent Retriever 同类。RAPTOR 是树摘要方向的代表发表,工程上先父子检索再考虑摘要节点。

  • 风险:父块用整章摘要时,嵌入可能与细粒度问句不对齐,闸门关闭。

工程落地

最小可运行示例

复制为 .py 后直接运行(仅标准库)。父块是闸门:未命中的父节点不展开子块。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
"""先搜父索引,只在命中父节点下搜子块,再按 alpha 融合。"""
from __future__ import annotations

from dataclasses import dataclass


@dataclass
class Node:
node_id: str
text: str
parent_id: str | None = None


def overlap(query: str, text: str) -> float:
q, t = set(query.lower().split()), set(text.lower().split())
return len(q & t) / max(len(q), 1)


class ParentChildIndex:
"""父子两套索引。生产对应 LlamaIndex ParentDocumentRetriever。"""

def __init__(self, parents: list[Node], children: list[Node]) -> None:
self.parents = parents
self.children = children

def search(self, query: str, alpha: float = 0.4, parent_top_k: int = 1, child_per_parent: int = 6) -> list[tuple[str, float]]:
parents = sorted(self.parents, key=lambda n: -overlap(query, n.text))[:parent_top_k]
fused = []
for p in parents:
sp = overlap(query, p.text)
kids = [c for c in self.children if c.parent_id == p.node_id]
kids = sorted(kids, key=lambda c: -overlap(query, c.text))[:child_per_parent]
for c in kids:
fused.append((c.node_id, alpha * sp + (1 - alpha) * overlap(query, c.text)))
fused.sort(key=lambda x: -x[1])
return fused[:8]


if __name__ == "__main__":
parents = [Node("P-S-methods", "Methods GAPDH knockdown protocol")]
children = [
Node("C-S-methods-1", "20 nM siRNA targeting GAPDH", "P-S-methods"),
Node("C-S-methods-2", "48 h before RNA extraction", "P-S-methods"),
Node("C-other", "author contributions", "P-intro"),
]
print(ParentChildIndex(parents, children).search("48 h RNA extraction", alpha=0.4))

参数

参数 起点 影响
parent_chunk_level section 过粗则 $s_p$ 低,子块不展开
child_chunk_level paragraph 过碎则重复命中、噪声大
parent_top_k 3 闸门宽度
child_per_parent 6 每章展开预算
fusion_alpha 0.4 定义类问句可加大;数值类可减小

失效—信号—螺丝

  • 父块过粗:子块未展开。信号:父召回全 miss,子 Recall 为零。螺丝:父块改小节级,或降 $\alpha$ 并提高 parent_top_k
  • 子块过碎:证据重复。信号:同一事实占满 Top-n。螺丝:合并相邻句,开 dedupe_child_spans
  • $\alpha$ 一刀切:定义问 vs 数值问最优不同。信号:分场景 nDCG 分叉。螺丝:按查询类型调 $\alpha$ 或走 Router。

规模(100 篇生物学 PDF)

假设约 100 篇。索引体积约为扁平策略 1.2–1.8×;内存 +15–30%。建库较扁平切分 +30%–70% 离线时间。在线多一次父检索。

-------------本文结束感谢您的阅读-------------