「只要小鼠、只要 2023 年后」这类条件,相似度检索无法当硬保证。根因是语义得分没有逻辑完备性。本方法用 AND/OR/NOT(或过滤器)先收缩集合。它不负责语义排序,通常作前置筛。
本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「Boolean Retrieval」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 元数据/词项的硬过滤 |
| 输入 → 输出 | 过滤条件 → 文档子集 $U’$,再可选语义排序 |
| 默认组合 | 带列/payload 过滤的索引均可:ES filter、Qdrant/Milvus payload、SQL WHERE |
| 何时不用 | 没有可结构化的约束字段,问句全是流畅语义 |
核心机制
$$
U’=\bigl(A\cap B\bigr)\setminus C
$$
在 $U’$ 上再跑 dense。底层是集合运算,不是打分。
段末注释:$U’$ = 硬约束收完后的候选全集;语义近邻只允许在这个子集里发生。
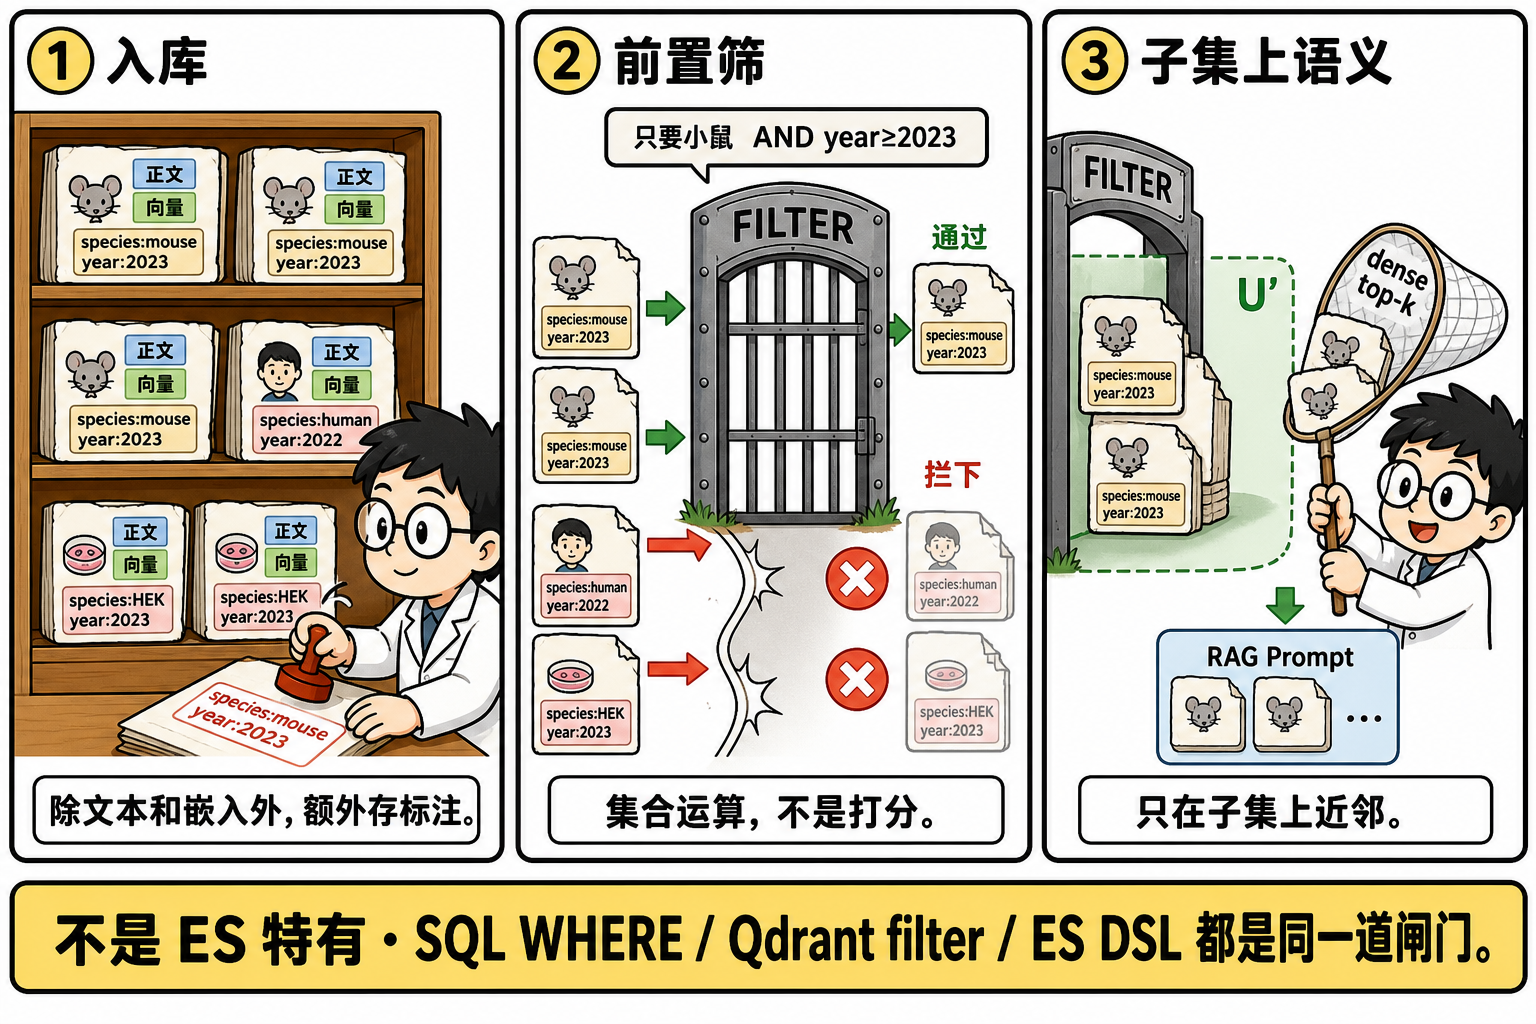
实现路径与心智:离线把物种/年份/权限写成 chunk 旁的结构化字段(或正文倒排);线上先把硬约束编成交、并、差,得到 $U’$,再可选地在 $U’$ 上跑语义。底层心智:布尔是闸门不是排序器——它保证「必须满足」的完备性,不保证相关排序。语义检索不能替代这道硬收缩。
前置条件
缺任一条,这道闸门无效或系统性空集:
- 入库已有结构化字段。除正文和嵌入外,必须把
species、year、journal、visibility等写进列/payload;用时再抽标注来不及。 - 问句能抽出硬约束。「只要小鼠、只要 2023 年后」可编译成过滤器;全是流畅语义则不要走本方法。
- 枚举与语料一致。
mouse与Mus musculus、缺字段、拼写漂移都会变成空集。 - 硬条件走 filter。进打分上下文会把「匹配了字段但语义无关」的文档抬到前面。
实现方式
不是 Elasticsearch / OpenSearch 特有功能。本质与 SQL 相同:额外存标注 → 使用阶段先按标注收集合 → 只把满足约束的记录交给后续 RAG。 领域特定语言(Domain-Specific Language,DSL)只是把这道闸门写成查询语法的一种方式。
段末注释:DSL 此处指搜索引擎的查询语法(如 ES Query DSL);换成
WHERE或 payload filter,集合语义不变。
两层不要混:
| 元数据过滤(标注查库) | 经典布尔检索(倒排词项) | |
|---|---|---|
| 存什么 | species、year、visibility 等字段 |
正文分词后的倒排 |
| 问什么 | species=mouse AND year≥2023 |
GAPDH AND knockdown NOT review |
| 保证什么 | 标注必须命中,否则剔除 | 词必须按布尔式出现 |
| 谁都能做 | MySQL / PostgreSQL / Qdrant / Milvus / pgvector | 倒排引擎更擅长;SQL LIKE 能做但不适合大规模 |
文中样例 species:mouse AND year>=2023 AND NOT review:true 主要是第一层。落地时三条等价路径:
- SQL / pgvector:列过滤后再近邻。
- 向量库 payload filter:Qdrant / Milvus / Weaviate 先 filter 再 ANN。
- ES / OpenSearch:filter context 做硬约束(可顺带做第二层词项布尔);不要把硬条件放进 query 打分。
优缺点
- 优点:合规与硬约束可证明。
- 缺点:字段缺失或标注错则系统性空集。
契约与走通样例
输入
1 | {"query": "GAPDH knockdown timing", "dsl": "species:mouse AND year>=2023 AND NOT review:true"} |
中间量
全库 8000 chunks → 过滤后 420。其中金标准 48 h 段仍在;$U’$ 外的人源 HEK 段被剔除。
输出
1 | {"universe_size": 420, "hits": [{"doc_id": "P-GAPDH-mm-02-C1"}]} |
社区实现
默认 Elasticsearch / OpenSearch 的 filter context(Query DSL)。等价实现:Qdrant/Milvus payload filter、pgvector + WHERE。风险:filter 与 query 混用导致相关性被过滤条件稀释;硬约束应走 filter。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。生产把 FilterThenDenseIndex 换成 ES filter / Qdrant payload / SQL WHERE + ANN。
1 | """先按标注做集合收缩,再在子集 U' 上词袋余弦。""" |
SQL 等价(第一层):
1 | SELECT * |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
filter_fields |
species, year, journal, visibility | 缺字段等于过滤失效 |
| 过滤语法 | 与元数据枚举一致 | 拼写不一致会空集 |
失效—信号—螺丝
- 空集:枚举值和语料不一致。信号:命中 0。螺丝:检查元数据规范化。
- 人写 AND 过严:漏召回。螺丝:把不确定条件改成语义。
- 用 bool query 当打分:不相关但匹配字段的文档排前。螺丝:硬条件走 filter。
规模(100 篇生物学 PDF)
倒排/列过滤为主,内存 4–12 GB,GPU 非必需。建倒排 5–30 min。在线亚毫秒到数毫秒。