把整段压成一个向量后,问句里的短语无法和段落里的对应 token 对齐。根因是早交互被丢掉。本方法用延迟交互(late interaction)下的 MaxSim。默认必须两阶段粗排,否则时延与索引体积会爆。本阶段输出停在排序列表,不负责生成答案。
本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「ColBERT Retrieval」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 索引召回节点的 token 级精匹配 |
| 输入 → 输出 | 查询与文档的 token 向量序列 → [{doc_id, score}] |
| 默认组合 | BM25 或 dense top-200 → ColBERT 精排 top-50 |
| 何时不用 | 纯关键词硬过滤(Boolean);磁盘紧张;P95 必须 $<50,\mathrm{ms}$ 且无 GPU |
核心机制
文档与查询各自先编码成 token 向量,匹配阶段再交互,而不是把整段压成一个向量。
$$
S(q,d)=\sum_{i\in q}\max_{j\in d}\cos(q_i,d_j)
$$
段末注释:延迟交互(late interaction) = 两侧独立编码后再做 token 级匹配;MaxSim = 每个查询 token 在文档 token 中取最大余弦再求和。
比单向量 dense 细(短语能对上),比查询-文档全交叉注意力省(编码可离线)。长文档上 $S(q,d)$ 会被无关 token 抬高,必须先切段再编索引。
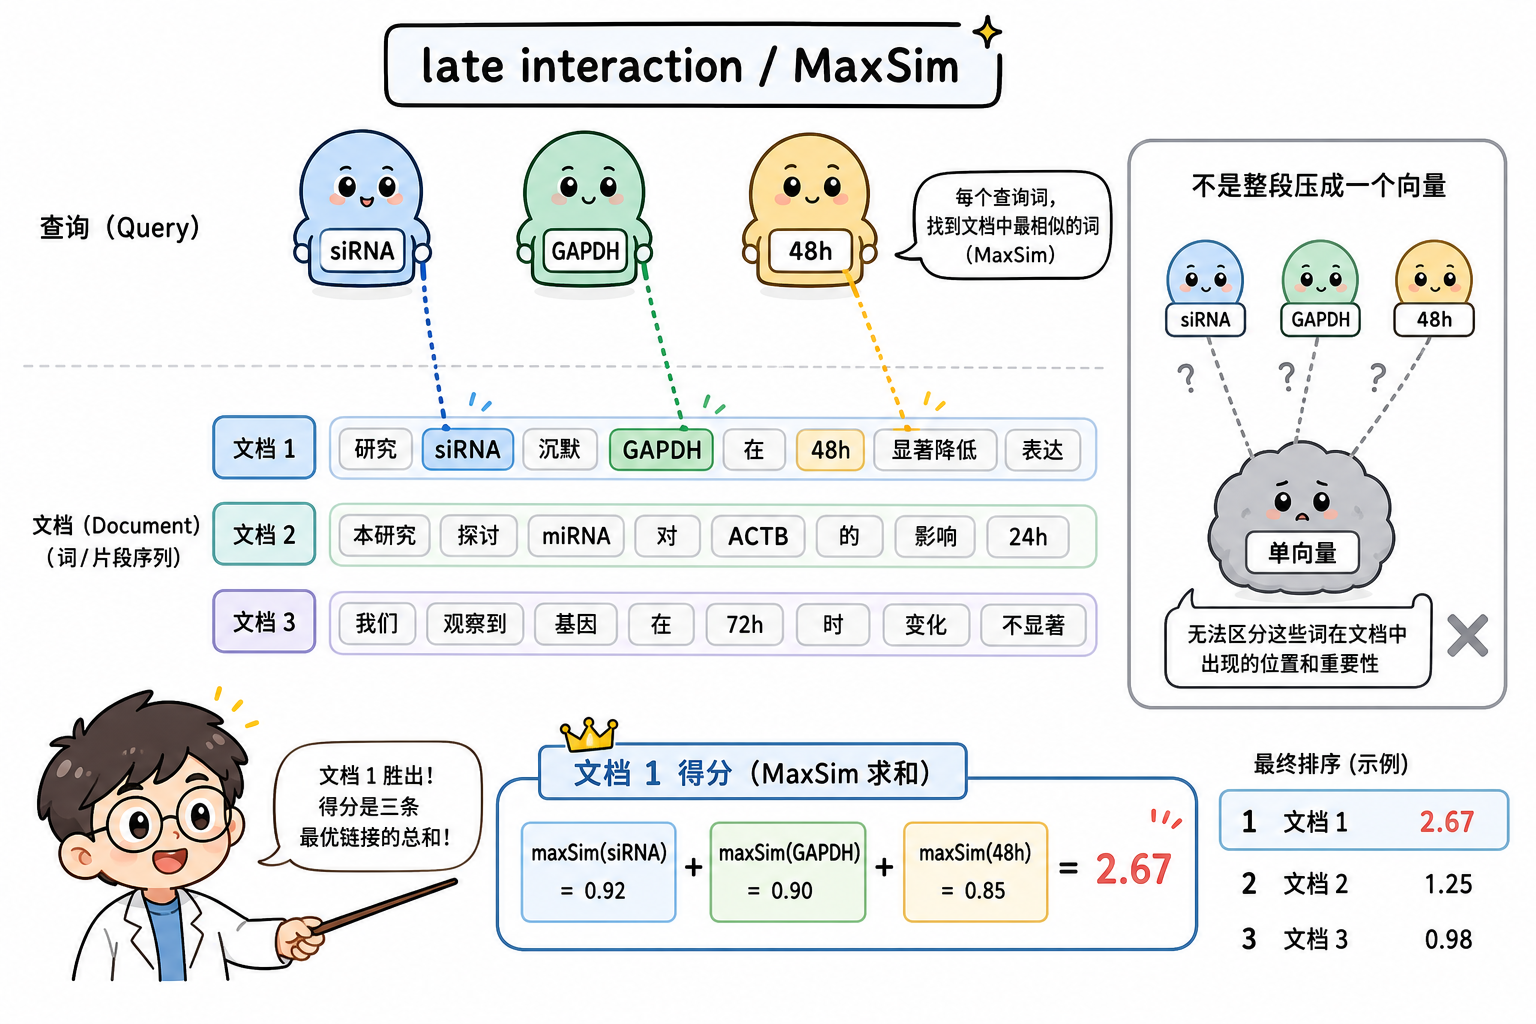
实现路径与心智:离线把每个 chunk 编成一袋 token 向量(可压缩/倒排)写入索引;线上只把查询编成少量 token 向量,对 stage-1 候选逐篇算 MaxSim。底层心智:匹配从「点对点」改成「每个查询 token 在文档里找一个证人再求和」。索引里存的不是 $\mathbb{R}^d$ 里的一个点,而是 token 袋;所以必须先切段、必须两阶段,否则袋太大、算不完。
优缺点
- 优点:复杂长句、近义改写下 nDCG 通常高于单向量;可解释到「哪个查询 token 对上了哪一段」。
- 缺点:索引常到数 GB~十几 GB(100 篇生物学量级);在线全库 MaxSim 时延不可接受。
契约与走通样例
本阶段不生成答案。下游若要引用,用 doc_id 回填原文 span。
输入
1 | { |
中间量
简化为两个查询子词 $q_1,q_2$ 与两篇文档:
| 文档 | $\max_j\cos(q_1,d_j)$ | $\max_j\cos(q_2,d_j)$ | $S(q,d)$ |
|---|---|---|---|
| P-GAPDH-01-C1(含 48 h + RNA extraction) | 0.80 | 0.75 | 1.55 |
| P-ACTB-09-C3(只含 extraction,无 48 h) | 0.61 | 0.70 | 1.31 |
选 P-GAPDH-01-C1。
输出
1 | [ |
社区实现
默认 RAGatouille(封装 Stanford colbert-ai / ColBERTv2)。Vespa 有生产级 late interaction,适合已有 Vespa 的团队。
- 场景:高精度段落检索、方法细节对齐。
- 接法:stage-1 用 BM25 或 dense 收 100~200 条,stage-2 只对候选算 MaxSim。
- 风险:文档截断
doc_max_tokens过短会切掉时程/剂量;过长则噪声 token 抬分。索引体积与 token 数近似线性,100 篇未切段时很容易到 8–25 GB。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。生产 MaxSim 用 colbert-ai / RAGatouille;本例用手写二维单位向量演示 late interaction。
1 | """每个 query token 对文档 token 取最大余弦再求和。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
stage1_top_n |
200 | 过小漏召回,MaxSim 救不回;过大在线 GPU 线性涨 |
colbert_rerank_top / $k$ |
50 | 交给重排或生成的条数;过大浪费上下文 |
query_max_tokens |
32 | 过短丢掉约束词(48 h、nM) |
doc_max_tokens |
180 | 过长噪声抬分;过短切掉方法约束。应先按切分策略成段 |
| 相似度 | 余弦(向量需归一化) | 未归一化时 max 无意义 |
评测用冻结切分后的 nDCG@k / MRR,不要用 Faithfulness。
失效—信号—螺丝
- 在线全库 MaxSim:P95 从百毫秒跳到数秒。信号:GPU 利用率打满且
stage1_top_n等于全库。螺丝:强制两阶段,先 BM25/dense。 - 长文未切段:不相关综述段得分虚高。信号:命中文档很长、span 对不上问句约束。螺丝:先跑 Chunking-centric,再对 chunk 建 ColBERT 索引。
- 中英混检:子词对不齐,局部 max 失效。信号:同义英文问、中文库(或相反)nDCG 塌。螺丝:查询改写到与语料同一语言,或双语 ColBERT 检查。
规模(100 篇生物学 PDF)
约 3k–8k chunks 时:建库 2–8 GPU·h(A10 24GB),索引常 8–25 GB。在线应只跑候选集:每问额外数十到数百毫秒量级,取决于 stage1_top_n。