Hybrid-RAG

纯稠密向量经常找不到基因符号、试剂货号;纯 BM25 找不到同义改写。根因是词项精确与语义近似不可互相替代。本方法两路召回再融合。分数尺度不同,必须走 Fusion/RRF,不能直接加分。

本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「Hybrid RAG」方法。

定位

维度 内容
角色 词项通道 + 语义通道的并行召回
输入 → 输出 query → 两路排名 → RRF 后的 hits
默认组合 OpenSearch / Elasticsearch hybrid,或 Weaviate / Milvus 稀疏+稠密
何时不用 语料全是流畅叙述、几乎无符号货号,且 Naive 已够

核心机制

$$
\mathrm{RRF}(d)=\sum_i \frac{1}{k+\mathrm{rank}_i(d)}
$$

$k$ 为平滑常数(常用 60)。可比的是名次,不是 BM25 与余弦的原值。

段末注释:倒数排名融合(Reciprocal Rank Fusion,RRF) = 按各通道排名倒数加权,避免分数尺度问题。
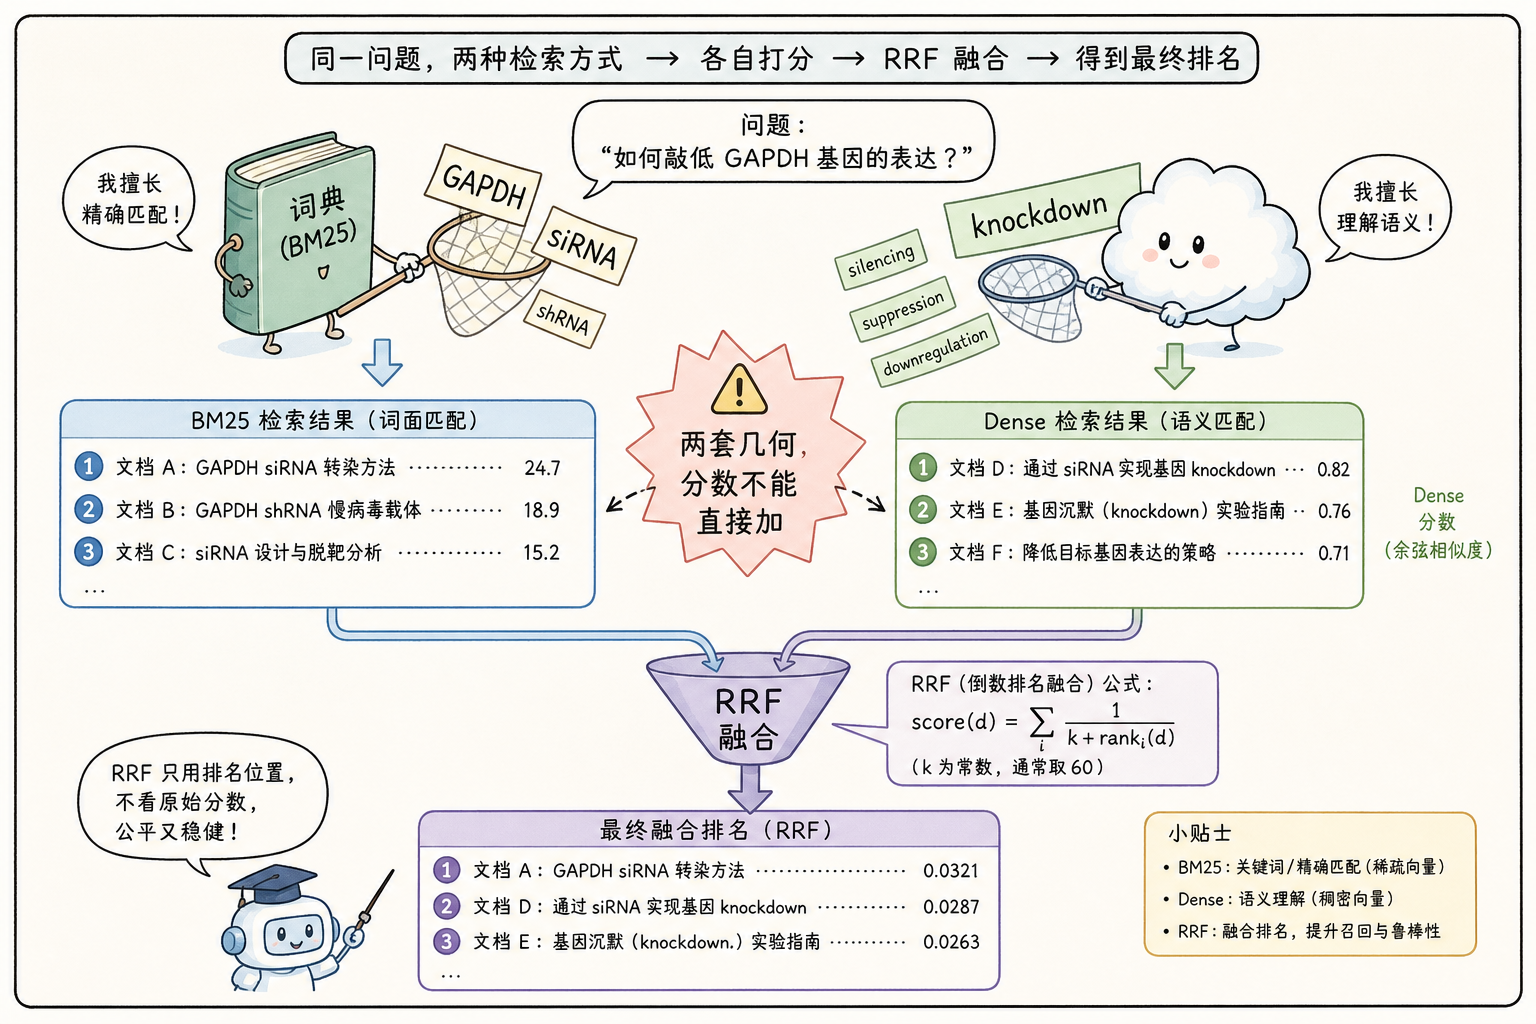
图 1 词项网接住 GAPDH/siRNA,语义网接住改写;RRF 漏斗合并,原始分不能加

实现路径与心智:同一 query 并行打倒排(词项)和向量 ANN(语义),得到两份排名,用 RRF 或校准后的分融合、去重。底层心智:这是两套几何里的相关性,BM25 分和余弦不在同一尺度,禁止直接相加。词项通道负责货号/基因符号,向量通道负责改写同义。

优缺点

  • 优点:术语与同义同时覆盖。
  • 缺点:两套索引;融合参数仍要评测。

契约与走通样例

输入

1
{"query": "GAPDH siRNA 20 nM 处理多久"}

中间量

BM25:含 GAPDH 的块 rank=1;dense:改写段 rank=1、货号段 rank=8。RRF($k=60$)后货号段升到 rank=2,Recall@5 从单路 $0.6$ 到 $1.0$。

输出

1
[{"doc_id": "P-GAPDH-01-C1", "rrf": 0.0328, "ranks": {"bm25": 1, "dense": 8}}]

社区实现

OpenSearch / Elasticsearch hybrid。风险:默认加权仍在加原始分——关掉,改 RRF。

工程落地

最小可运行示例

复制为 .py 后直接运行(仅标准库)。生产两路分别走 ES BM25 与向量 ANN,融合用 ES RRF,禁止加原始分。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
"""BM25 式词项分与余弦分各排一列,再用 RRF 合名次。"""
from __future__ import annotations

import math
from collections import Counter
from dataclasses import dataclass


@dataclass
class Chunk:
"""双通道共享的语料单元。"""

doc_id: str
text: str


def tokenize(text: str) -> list[str]:
return text.lower().split()


class Bm25Ranker:
"""极简 BM25。生产对应 Elasticsearch match / BM25Similarity。"""

def __init__(self, chunks: list[Chunk], k1: float = 1.2, b: float = 0.75) -> None:
self.chunks = chunks
self.k1, self.b = k1, b
self.dl = [len(tokenize(c.text)) for c in chunks]
self.avgdl = sum(self.dl) / max(len(chunks), 1)
df: Counter[str] = Counter()
for c in chunks:
df.update(set(tokenize(c.text)))
n = len(chunks)
self.idf = {t: math.log((n - f + 0.5) / (f + 0.5) + 1) for t, f in df.items()}

def rank(self, query: str, top_k: int) -> list[str]:
q = tokenize(query)
scores = []
for c, dl in zip(self.chunks, self.dl):
tf = Counter(tokenize(c.text))
s = 0.0
for t in q:
f = tf[t]
s += self.idf.get(t, 0.0) * (f * (self.k1 + 1)) / (f + self.k1 * (1 - self.b + self.b * dl / self.avgdl))
scores.append((c.doc_id, s))
scores.sort(key=lambda x: -x[1])
return [d for d, _ in scores[:top_k]]


class DenseRanker:
"""词袋余弦。生产对应 FAISS + bge-m3。"""

def __init__(self, chunks: list[Chunk]) -> None:
self.chunks = chunks

def rank(self, query: str, top_k: int) -> list[str]:
q = Counter(tokenize(query))
scored = []
for c in self.chunks:
d = Counter(tokenize(c.text))
keys = set(q) | set(d)
dot = sum(q[t] * d[t] for t in keys)
scored.append((c.doc_id, dot))
scored.sort(key=lambda x: -x[1])
return [i for i, _ in scored[:top_k]]


def rrf(rank_lists: list[list[str]], k: int = 60) -> list[str]:
"""倒数排名融合。生产对应 Elasticsearch RRF。"""
scores: dict[str, float] = {}
for lst in rank_lists:
for rank, doc_id in enumerate(lst, start=1):
scores[doc_id] = scores.get(doc_id, 0.0) + 1.0 / (k + rank)
return [d for d, _ in sorted(scores.items(), key=lambda x: -x[1])]


if __name__ == "__main__":
corpus = [
Chunk("P-GAPDH-01-C1", "GAPDH siRNA 20 nM catalog D-001234"),
Chunk("P-para", "knock down glyceraldehyde expression by silencing"),
]
fused = rrf(
[
Bm25Ranker(corpus).rank("GAPDH siRNA 20 nM 处理多久", 2),
DenseRanker(corpus).rank("GAPDH siRNA 20 nM 处理多久", 2),
]
)
print(fused)

参数

参数 起点 影响
每路 top_k 50 融合池宽度
RRF $k$ 60 越小越惩罚靠后的名次
top_n 20 交给精排或生成

失效—信号—螺丝

  • 直接加分:某一通道主导。信号:一路分数量纲大一个数量级。螺丝:改 RRF。
  • 货号仍漏:BM25 分析器切碎符号。螺丝:keyword 字段 / n-gram。
  • 近重复占满:两路同一段。螺丝:按 chunk_id 去重。

规模(100 篇生物学 PDF)

倒排+向量磁盘 约 2–6 GB;建库 0.6–2 GPU·h(含 BM25)。在线两路并行,时延接近较慢的那一路。

-------------本文结束感谢您的阅读-------------