小规模高价值库上,检索链路的漏检与拼接损失,可能大于把原文送进长窗口的成本。根因是检索引入的信息损失大于注意力稀释(仅在库很小、文档很值钱时成立)。本方法减少检索跳数(retrieval hop)。100 篇论文不能一次塞完,仍要批次或检索前置。
本文属于 RAG 工程框架中的「4 生成与智能体编排」环节,聚焦「Long Context RAG」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 用长窗口减少检索跳数 |
| 输入 → 输出 | 选中的原文段(有序)→ 生成 |
| 默认组合 | Qwen-long / Claude / 本地 vLLM 长窗口 |
| 何时不用 | 大库、成本敏感、中间段关键(lost-in-the-middle) |
核心机制
把段按相关与阅读顺序装入窗口 $W$,为答案留 $R$ token:$\sum |s_i| \le W-R$。注意力非均匀。
段末注释:检索跳数(retrieval hop) = 生成前的一次独立检索/召回回合(改写再搜、多路召回、精排、压缩后再搜都各算一跳)。不是图上的 $k$-hop。
定义
减少检索跳数 = 少做几轮「先搜再拼」,把更多原文直接装进长窗口再生成。
常见链路里每一轮都可能漏掉金标准段,或把方法句拆碎:
- 改写查询再搜
- Hybrid / 多路召回
- 精排
- 压缩后再塞进 prompt
小库上这种漏检 + 拼接损失,可能比多付 token、把 Methods 原文送进 32k/128k 窗口更亏。本方法砍掉中间几跳:粗选几篇/几段 → 按序装箱 → 生成。极限接近 0 跳(整份短文档直接进窗);通常仍留 1 跳粗选(否则 100 篇一次塞不完)。
| 本文的跳 | 容易混淆的「跳」 | |
|---|---|---|
| 含义 | 生成前的检索回合 | 图上沿边走邻居;或 Agent 再检索 |
| 本方法 | 减少这些回合 | Graph 的 $k$-hop、Agentic 的多步检索是在加跳 |
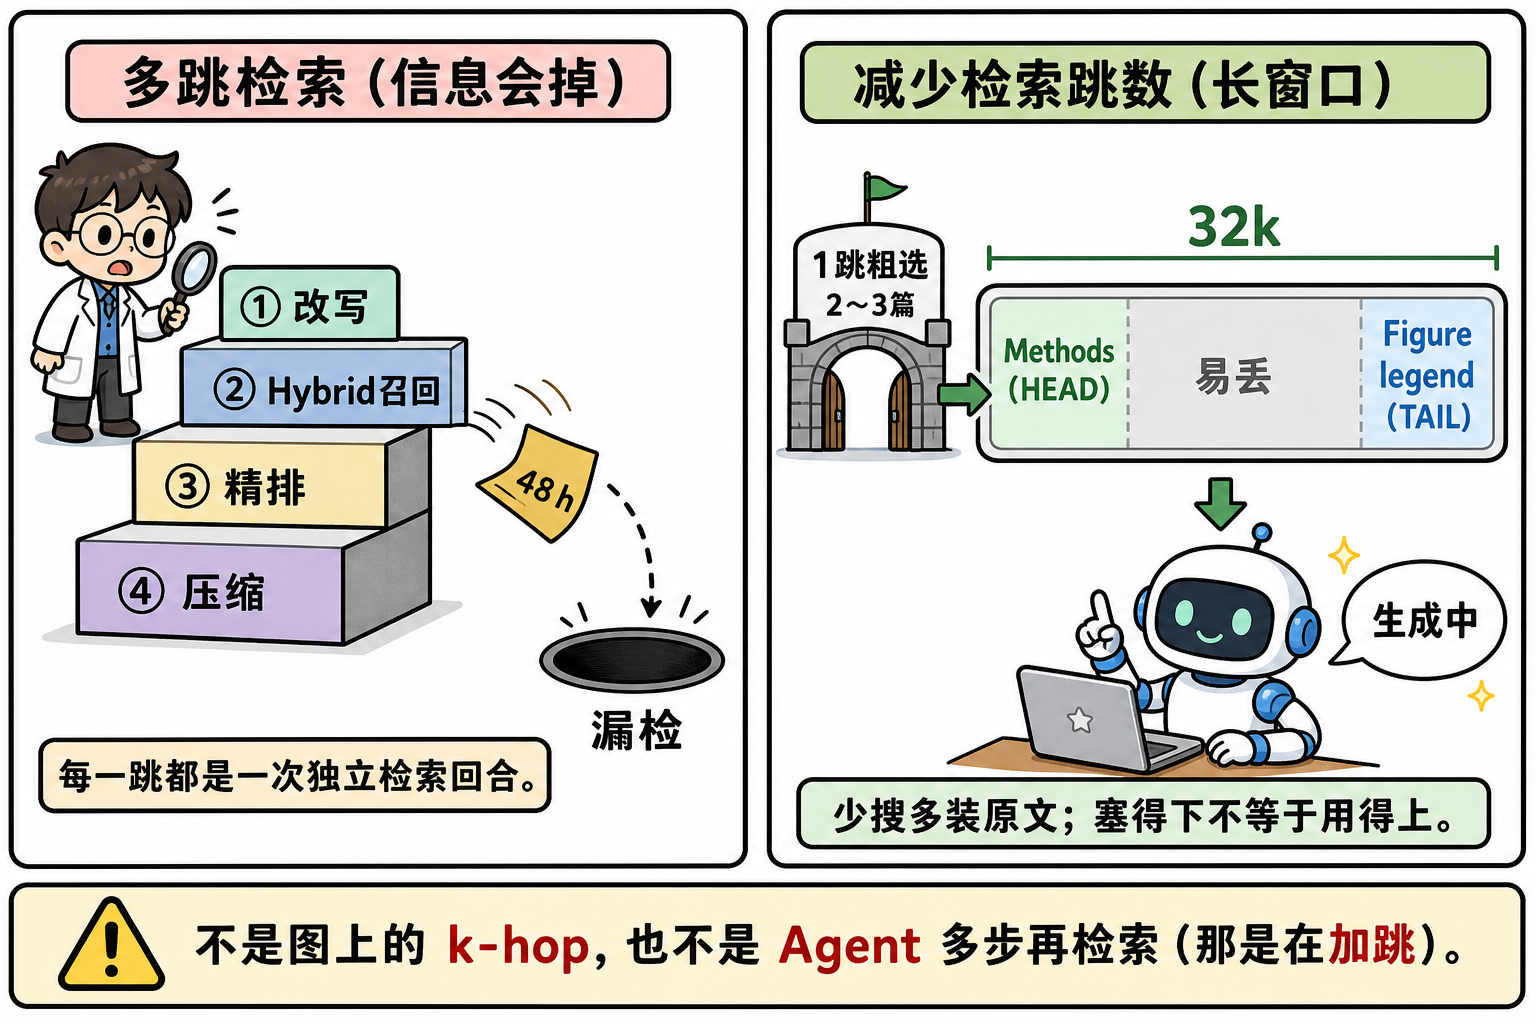
实现路径与心智:少检索跳数,按相关与阅读顺序把原文段装进长窗口。底层心智:注意力不是均匀的,中间段更容易丢;「塞得下」不等于「用得上」。
优缺点
- 优点:链路短。
- 缺点:token 贵;中间信息易丢。
契约与走通样例
输入
1 | {"query": "Summarize GAPDH siRNA protocol", "window": 32000} |
中间量
Methods 段放窗口头部,Figure legend 放尾,避免夹在中间。一次仍只装 2~3 篇,不是 100 篇。
输出
停在「已装箱的 prompt 段列表 + 生成答案」。证据仍应可回溯到 doc_id。
社区实现
长上下文模型 + vLLM。风险:宣传窗口远大于有效注意力。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。生产窗口长度读模型 max_position_embeddings;重要段放头或尾,避免 lost-in-the-middle。
1 | """按相关排序后顺序装箱,给答案预留 token。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
reserve_for_answer |
1k~2k | 不够则截答案 |
| 重要段位置 | 头或尾 | 避免 lost-in-the-middle |
失效—信号—螺丝
- 关键句在中间:Faithfulness 掉。螺丝:把金标准段提前。
- 一次塞 100 篇:费用爆炸且稀释。螺丝:批次或仍检索前置。
- 短库仍上长窗:浪费。螺丝:回到 Hybrid。
规模(100 篇生物学 PDF)
显存 20–40 GB 或按 token 计费。单次深度问答约 15–90 s;不是一次吃完 100 篇。