Graph-RAG

「A 调控 B、B 影响表型」无法靠两段各自相似拼出因果链。根因是段落相似度没有边。本方法先抽实体关系再子图扩展、回填原文。上限绑在抽取质量上,更新成本高。

本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「Graph RAG」方法。

定位

维度 内容
角色 多跳关系检索
输入 → 输出 query → 种子实体 → 子图 → 节点回填的 chunks
默认组合 生产综述用 Microsoft GraphRAG;轻量用 LightRAG + Neo4j
何时不用 无稳定实体关系、语料常改且抽不起;单跳事实用 Hybrid 即可

核心机制

$$
G^\star=\arg\max_{G\subseteq k\text{-hop}(e_{\mathrm{seed}})};\mathrm{rel}(q,G)
$$

再 $\mathrm{text}(v)$ 回填。匹配发生在边上。
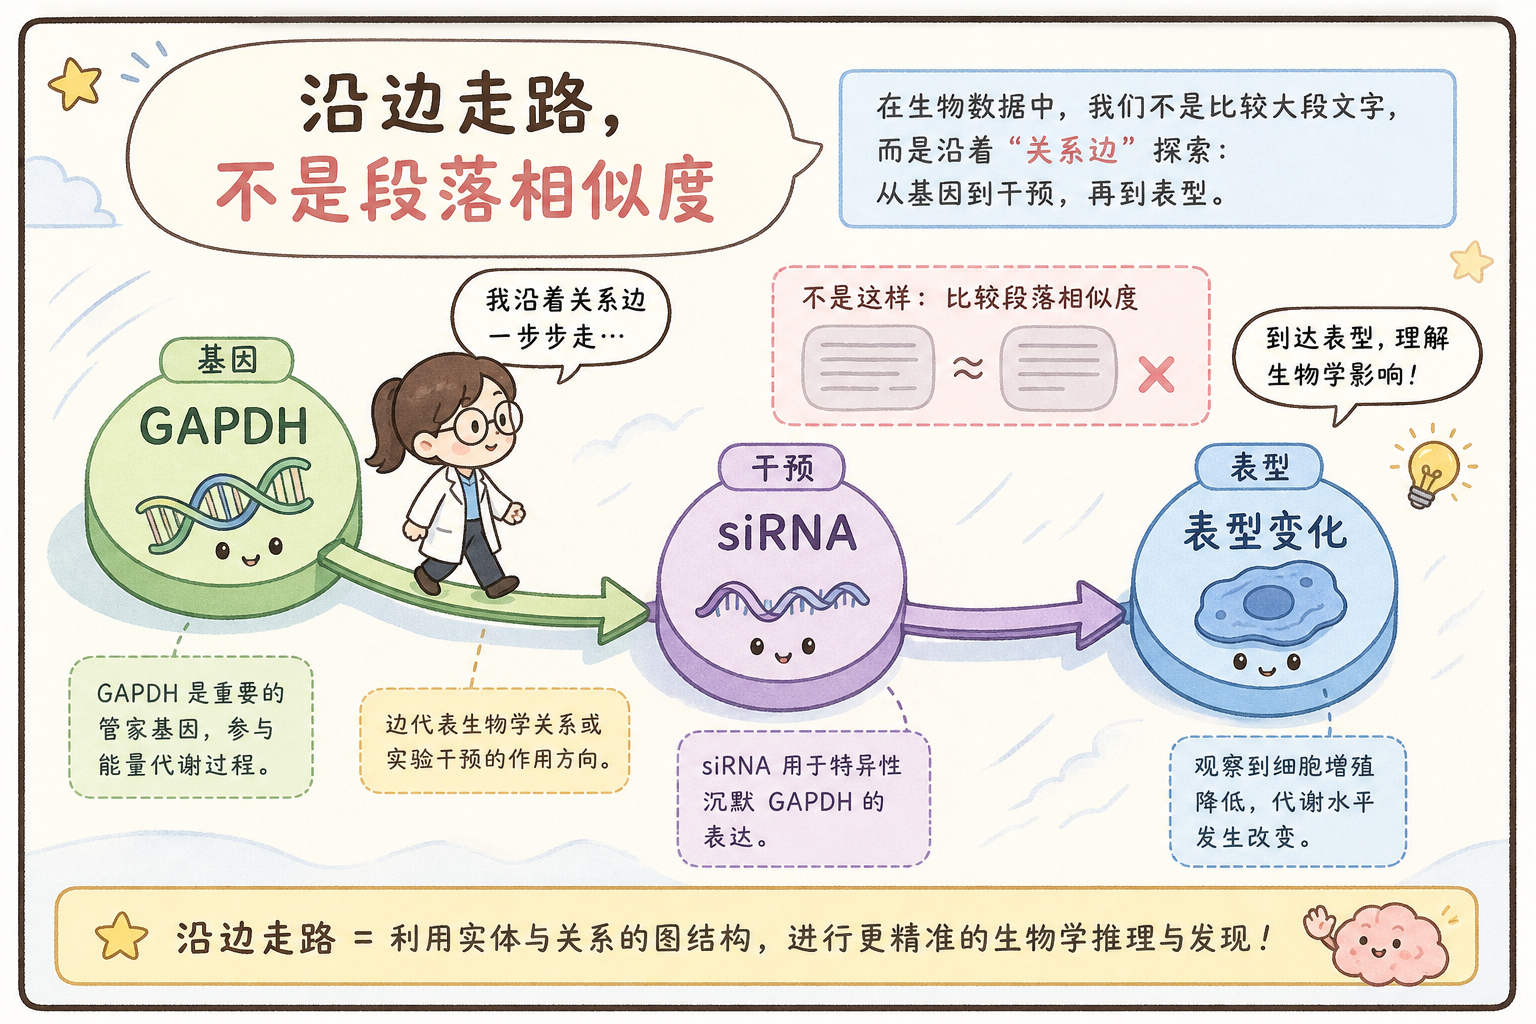
图 1 沿 GAPDH→siRNA→表型走边,而不是比较两段散文是否相似

实现路径与心智:离线抽三元组写入图库并保留节点到原文 chunk 的回指;线上把问句链到种子实体,按跳数扩子图,再取节点上的文本。底层心智:检索是沿边走路,不是给段落打相似度。上限绑在抽取与实体链接上——链错种子,后面跳得越远错得越大。

优缺点

  • 优点:多跳与全局摘要类问题强。
  • 缺点:IE 贵;图更新与一致性难。

契约与走通样例

输入

1
{"query": "GAPDH knockdown 如何影响糖酵解表型?"}

中间量

种子 GAPDH,2-hop 覆盖边 knockdown→siRNAGAPDH→glycolysis。子图相关 $0.82$ > 单段向量 $0.55$。回填 Methods + Results 两段。

输出

1
2
3
4
5
{
"seed": "GAPDH",
"edges": [["GAPDH", "knockdown", "siRNA"], ["GAPDH", "affects", "glycolysis"]],
"chunks": ["P-GAPDH-01-C1", "P-GAPDH-01-C7"]
}

社区实现

Microsoft GraphRAG(社区摘要);轻量 LightRAG + Neo4j。风险:抽取噪声边会被多跳放大。

工程落地

最小可运行示例

复制为 .py 后直接运行(仅标准库)。生产实体链接/图存储换成 spaCy+词典 与 Neo4j / LightRAG。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
"""种子实体 → k-hop 子图 → 回填节点上的文本块。"""
from __future__ import annotations

from collections import defaultdict, deque


class EntityLinker:
"""别名 → 规范名。生产对应实体链接模型 + 基因别名表。"""

aliases = {"gapdh": "GAPDH", "p53": "TP53"}

def link(self, query: str) -> list[str]:
found = []
for token in query.replace("/", " ").split():
key = token.lower()
if key in self.aliases:
found.append(self.aliases[key])
return found


class GraphStore:
"""无向邻接表。生产对应 Neo4j / NetworkX 持久化图。"""

def __init__(self, edges: list[tuple[str, str]]) -> None:
self.adj: dict[str, set[str]] = defaultdict(set)
for a, b in edges:
self.adj[a].add(b)
self.adj[b].add(a)

def k_hop(self, seeds: list[str], hops: int) -> set[str]:
seen = set(seeds)
q: deque[tuple[str, int]] = deque((s, 0) for s in seeds)
while q:
node, dist = q.popleft()
if dist >= hops:
continue
for nxt in self.adj[node]:
if nxt not in seen:
seen.add(nxt)
q.append((nxt, dist + 1))
return seen


class TextIndex:
"""节点 id → 原文 chunk。生产对应向量库按 entity_id 反查。"""

def __init__(self, node_to_chunk: dict[str, str]) -> None:
self.node_to_chunk = node_to_chunk

def fetch_chunks(self, nodes: set[str]) -> list[str]:
return [self.node_to_chunk[n] for n in nodes if n in self.node_to_chunk]


if __name__ == "__main__":
seeds = EntityLinker().link("Does GAPDH regulate TP53?")
nodes = GraphStore([("GAPDH", "TP53"), ("TP53", "MDM2")]).k_hop(seeds, hops=2)
chunks = TextIndex(
{
"GAPDH": "GAPDH knockdown lowers TP53 transcription",
"TP53": "TP53 is a transcription factor",
"MDM2": "MDM2 binds TP53",
}
).fetch_chunks(nodes)
print(seeds, sorted(nodes), chunks)

参数

参数 起点 影响
max_hops 2 过大噪声爆炸
max_edges_per_hop 30 子图体积
text_backoff true 图空时退回向量

失效—信号—螺丝

  • 实体链接错:子图全偏。信号:种子不是问句主实体。螺丝:加别名表,低置信走向量 backoff。
  • 噪声边:多跳放大。螺丝:边置信阈值、人工抽检 IE。
  • 子图过大:回填超窗。螺丝:降 hops,或与压缩衔接。

规模(100 篇生物学 PDF)

图存储 2–10 GB;细粒度 IE 可达 5–25 CPU·h(甚至更长)。在线含子图搜索,中到高时延。

-------------本文结束感谢您的阅读-------------