关键证据在凝胶图、机制图、附表里,纯文本 chunk 根本没有该信号。根因是索引模态缺失。本方法对图文联合编码检索。它不替代 OCR/表格解析质量(仍依赖 Document Parsing)。
本文属于 RAG 工程框架中的「2 索引与召回」环节,聚焦「Multimodal RAG」方法。
定位
| 维度 | 内容 |
|---|---|
| 角色 | 跨模态检索 |
| 输入 → 输出 | 文本或图 query → 图块/文块统一排名 |
| 默认组合 | 文/图两路检索 + RRF 并表,再可选 VLM 精排;图问补 SigLIP/CLIP |
| 何时不用 | 纯文本库、图只是装饰 |
核心机制
图块和文本块是两类对象,进同一张排名表的前提是拿到可比较的分。加权和
$$
\mathrm{score}=w_t,\mathrm{score}{\mathrm{text}}+w_v,\mathrm{score}{\mathrm{vision}}
$$
只适用于「同一条记录同时有文分和图分」(例如一页里既有 OCR 又有渲染图)。异构块(段落 vs 凝胶图)要用下面四条路之一。图块必须有 figure_id 与 caption 对齐。
段末注释:联合嵌入(joint embedding) = 图和文编进同一向量空间再近邻检索;延迟融合(late fusion) = 两路先各自检索再并表;倒数排名融合(Reciprocal Rank Fusion,RRF) = 按名次倒数加权,不碰原始分。
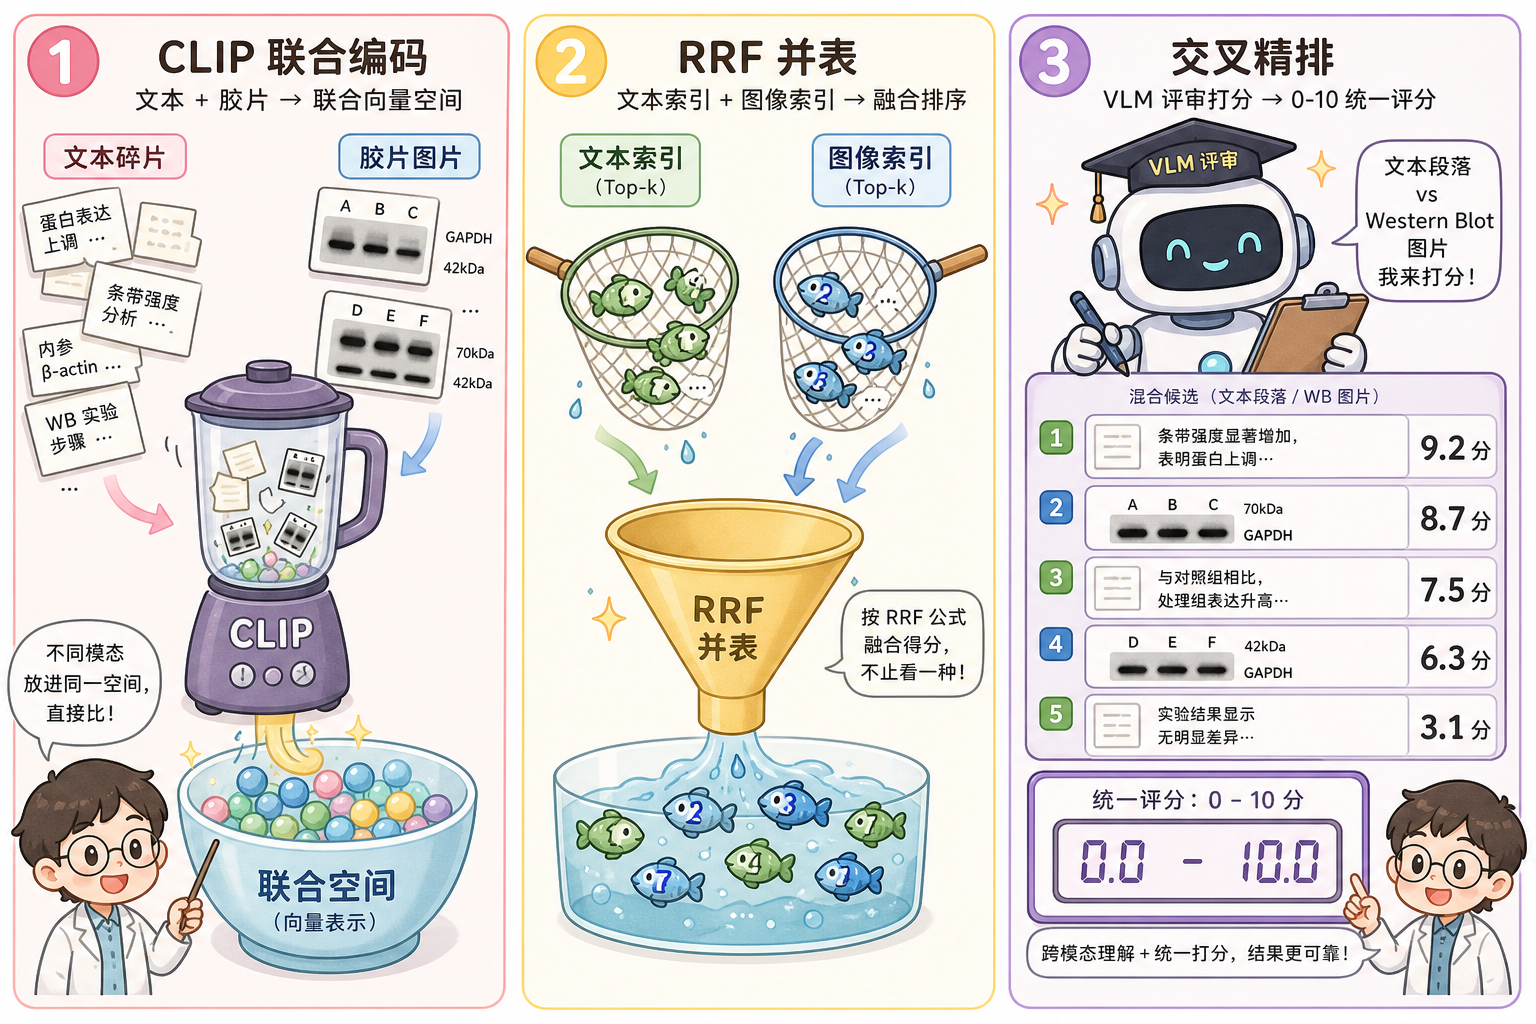
方式 1:联合空间(一张 ANN 表)
CLIP / SigLIP 把文本 chunk 与图块写成同一空间的向量,索引行是 {id, kind: text|figure, vector}。查询对全表余弦。分天生可比。
- 适配:lane / 条带位置等像素问句。
- 风险:模态间隙把图向量和文向量聚成两坨,图问挤掉正文。
方式 2:两路检索再并表(延迟融合,生产默认)
文走 BM25/bge,图走 SigLIP,两份名单并集去重后进一张表。图块通常没有合格的 score_text,禁止把 CLIP 余弦加 BM25。对齐用 RRF:
$$
\mathrm{RRF}(d)=\sum_i \frac{1}{k+\mathrm{rank}_i(d)}
$$
未出现在该路的 $\mathrm{rank}_i$ 视为 $\infty$。也可先 z-score 再加权,或先融页分再展开到块。
- 适配:期刊 PDF 正文+图+表混排。
- 风险:两路
top_k量级差太多,短名单通道被饿死。
方式 3:图转文后再进文本表
VLM 写 caption / 表转 Markdown,当文本 chunk 索引。表是统一的,信号全是字。
- 适配:有规范图注的机制示意图。
- 不适配:Western 的 lane——caption 写不出像素事实,正是本方法要打的失败。
方式 4:混合候选 + 跨模态精排
前三路任一先捞 20~50 条混合候选,再用多模 Cross-encoder 或 VLM-as-judge 打到同一 0–10 标尺,截 Top-n。ColPali / ColQwen 是变体:整页当图,query token 对 patch 做 MaxSim,产出页级统一排名。
- 适配:最终进生成窗口的顺序。
- 风险:贵,必须两阶段,不能全库 VLM。
生物学:lane/凝胶位置用 1 或 4,不要只用 3;文图都可能是证据时用 2 → 4。路由(图问只搜图)不是同一张表。
实现路径与心智:离线分别物化文本索引与图块索引(或一张联合向量表);线上按问句类型选 1/2/3,需要可比终排再走 4。底层心智:有些事实只存在于像素里,纯文本索引对该信号是零。并表解决的是分怎么对齐,不是「再加一个多模模型」。解析质量(OCR/图注对齐)决定图向量是否可检索,换编码器救不了切错的图。
优缺点
- 优点:图证可检。
- 缺点:索引与 GPU 显著更大。
契约与走通样例
输入
1 | {"query": "Which lane is GAPDH knockdown on the western blot?"} |
中间量(方式 2:RRF 并表)
文本路:Methods 段 rank=1,图块未进名单。图路:Figure 2B rank=1(像素含 lane),正文块未进名单。$k=60$ 时 Figure 2B 的 $\mathrm{RRF}=1/61\approx 0.0164$,Methods 段同样 $0.0164$;图问下保留 kind=figure 优先或再走方式 4。文本块不含 lane,单走文本 Recall@5=$0$。
方式 3 若 caption 只写 “Western blot of GAPDH”,图路仍排不出 lane。方式 1 对 Figure 2B 余弦 $0.81$、对正文 $0.22$,联合表上图块 rank=1。
输出
1 | [ |
社区实现
生产默认:方式 2(文本索引 + SigLIP/CLIP 图索引 + RRF);图问补联合空间或 方式 4(Qwen2.5-VL 打分)。整页视觉检索用 ColPali。风险:caption 没对齐时图向量检索到错误实验图;方式 3 单独上线会漏 lane 类问句。
工程落地
最小可运行示例
复制为 .py 后直接运行(仅标准库)。这是方式 2:文本路与图路各自出名单,RRF 并表。生产文本路用 bge,图路用 SigLIP/CLIP。
1 | """图块与文块不必有同一套原始分;只合并名次。""" |
参数
| 参数 | 起点 | 影响 |
|---|---|---|
| 并表方式 | 混排语料用 2;lane 问加 1 或 4;勿单独用 3 | 选错等于像素信号仍为零 |
每路 top_n |
同量级,如 50 | 差一个数量级则短名单被饿死 |
| RRF $k$ | 60 | 与 Fusion 同一平滑 |
| $w_v$ | 仅方式 1 的同记录加权;图问加大 | 异构块上没有 $s_t$ 可加 |
| 图切块 | 一图一块+caption;多 panel 切开 | 整页一块则 lane 被稀释 |
失效—信号—螺丝
- 图未进索引:图问 Recall=0。螺丝:解析阶段保留 figure blocks。
- caption 错配:命中错误实验。螺丝:强制 figure-caption 同源页。
- 只用方式 3:lane 问仍零召回。信号:图注命中、像素问失败。螺丝:上方式 1 或 4。
- CLIP 分加 BM25:一路主导。螺丝:改 RRF(方式 2)。
- 显存不够:螺丝:图离线编码,线上只检索向量;精排(方式 4)只打 Top-50。
规模(100 篇生物学 PDF)
GPU 24–48 GB 常见;多模索引显著大于纯文本。图编码+索引约 4–14 GPU·h。